

第七步:训练模型——ACT 训练命令
运行之前
- 环境:需要先按云GPU训练环境配置装好环境、把数据集传到云GPU上。ACT 是 LeRobot 基础环境自带的,不用额外安装
- 数据集:命令里的
--dataset.root=~/lerobot_my_dataset_shake_hands指向第六步采集的握手数据集。如果你训练的是自己的任务,把它换成你自己的数据集名 - 输出目录:
--output_dir如果已经存在,会直接报FileExistsError,换个新目录名,或者加--resume=true接着训练 - 训练中随时可以在 wandb 上看曲线,见 wandb查看实时训练曲线
参考文档
https://github.com/huggingface/lerobot/blob/main/src/lerobot/scripts/lerobot_train.py
https://github.com/huggingface/lerobot/blob/main/src/lerobot/configs/train.py
为什么从ACT算法开始
ACT是玩LeRobot最推荐训练的第一个模型,它的好处如下:
模型非常轻量,只有八千万个可学习参数
训练收敛速度很快,推理速度也很快
在单卡GPU上训练一个小时就能看到效果
ACT模型本身很小,压缩包大概200MB左右,非常便于存储和传输。训练产出的模型压缩包约300MB(见本篇末尾)
数据集采集30轮数据基本就够用了
可以部署在Ubuntu主机、Mac电脑、Windows电脑,甚至树莓派上推理
真实机器人推理效果还很不错,对于夹取、握手、放笔这类简单任务足够了
LeRobot库的基础环境中已经自带了ACT算法,无需安装其它库
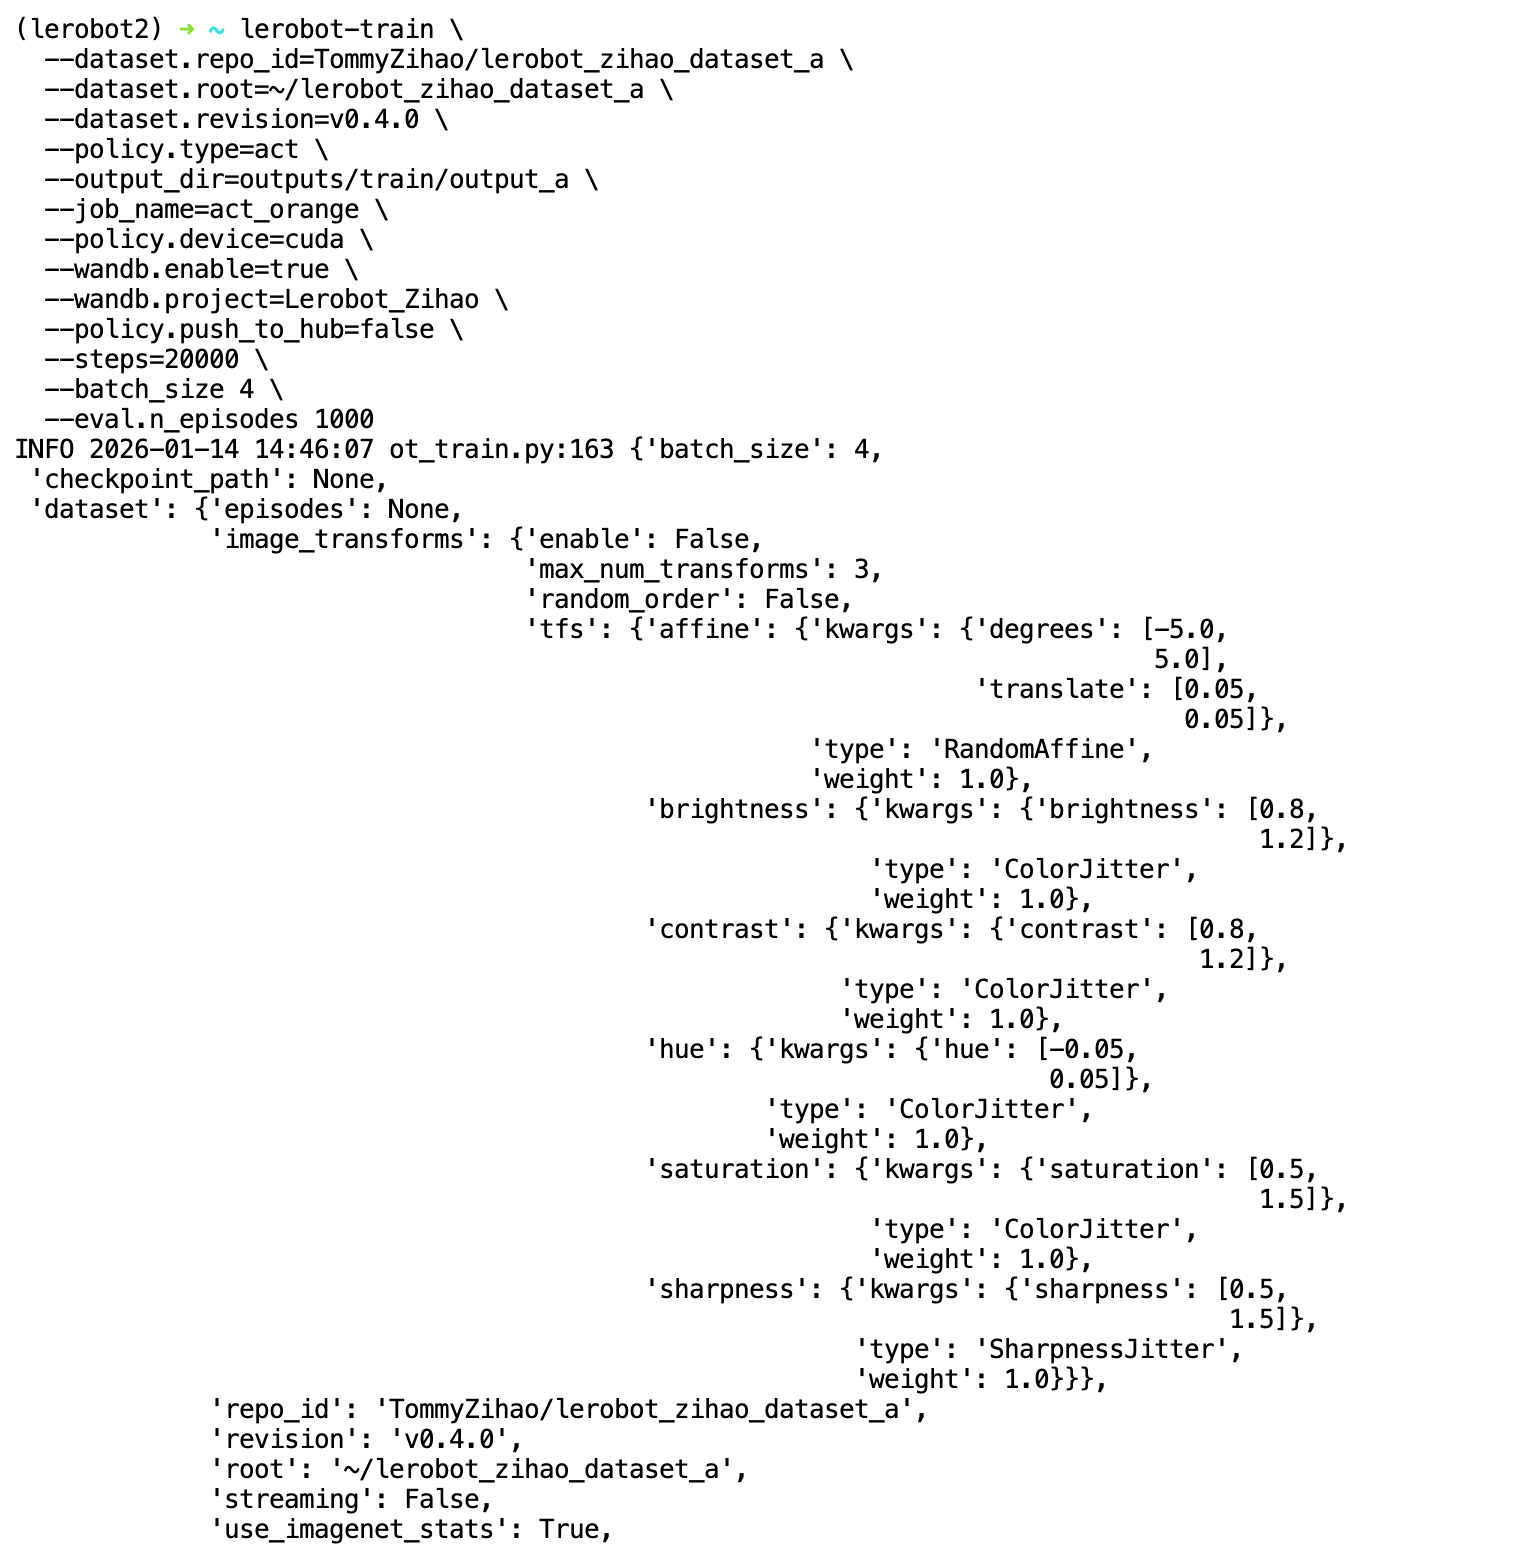
命令行
Shell
lerobot-train \
  --dataset.repo_id=<你的用户名>/lerobot_my_dataset_shake_hands \
  --dataset.root=~/lerobot_my_dataset_shake_hands \
  --dataset.revision=v0.1.0 \
  --dataset.streaming=false \
  --policy.type=act \
  --output_dir=~/output_lerobot_train/shake/act/ \
  --job_name=shake_act_a \
  --policy.device=cuda \
  --wandb.enable=true \
  --wandb.project=Lerobot_my_Project \
  --policy.push_to_hub=false \
  --steps=20000 \
  --batch_size=8
命令行说明
换行符``前面只能有一个空格,后面不能有空格
| 命令行参数 | 说明 |
|---|---|
| --dataset.repo_id | HuggingFace数据集的Repo_ID,形如用户名/数据集名 |
| --dataset.root | 数据集本地路径。数据集已经下载到本地时,要指向实际目录 |
| --dataset.revision | 数据集版本,在上传数据集到HuggingFace的时候指定过的 |
| --dataset.streaming | 是否流式读取。数据集在本地时设为false,无需流式读取 |
| --policy.type | 要训练的算法,比如act、smolvla、diffusion、pi0、pi05、pi0_fast、wall_x |
| --output_dir | 训练输出保存的目录 |
| --job_name | 本次训练任务的名字 |
| --policy.device | 计算设备 |
| --wandb.enable | 开启wandb可视化 |
| --wandb.project | wandb项目名称 |
| --policy.push_to_hub | 将训练好的模型发到HuggingFace云端 |
| --steps | 训练步数 |
| --batch_size | 一步输入的数据量,如果显存不够,应该调小 |
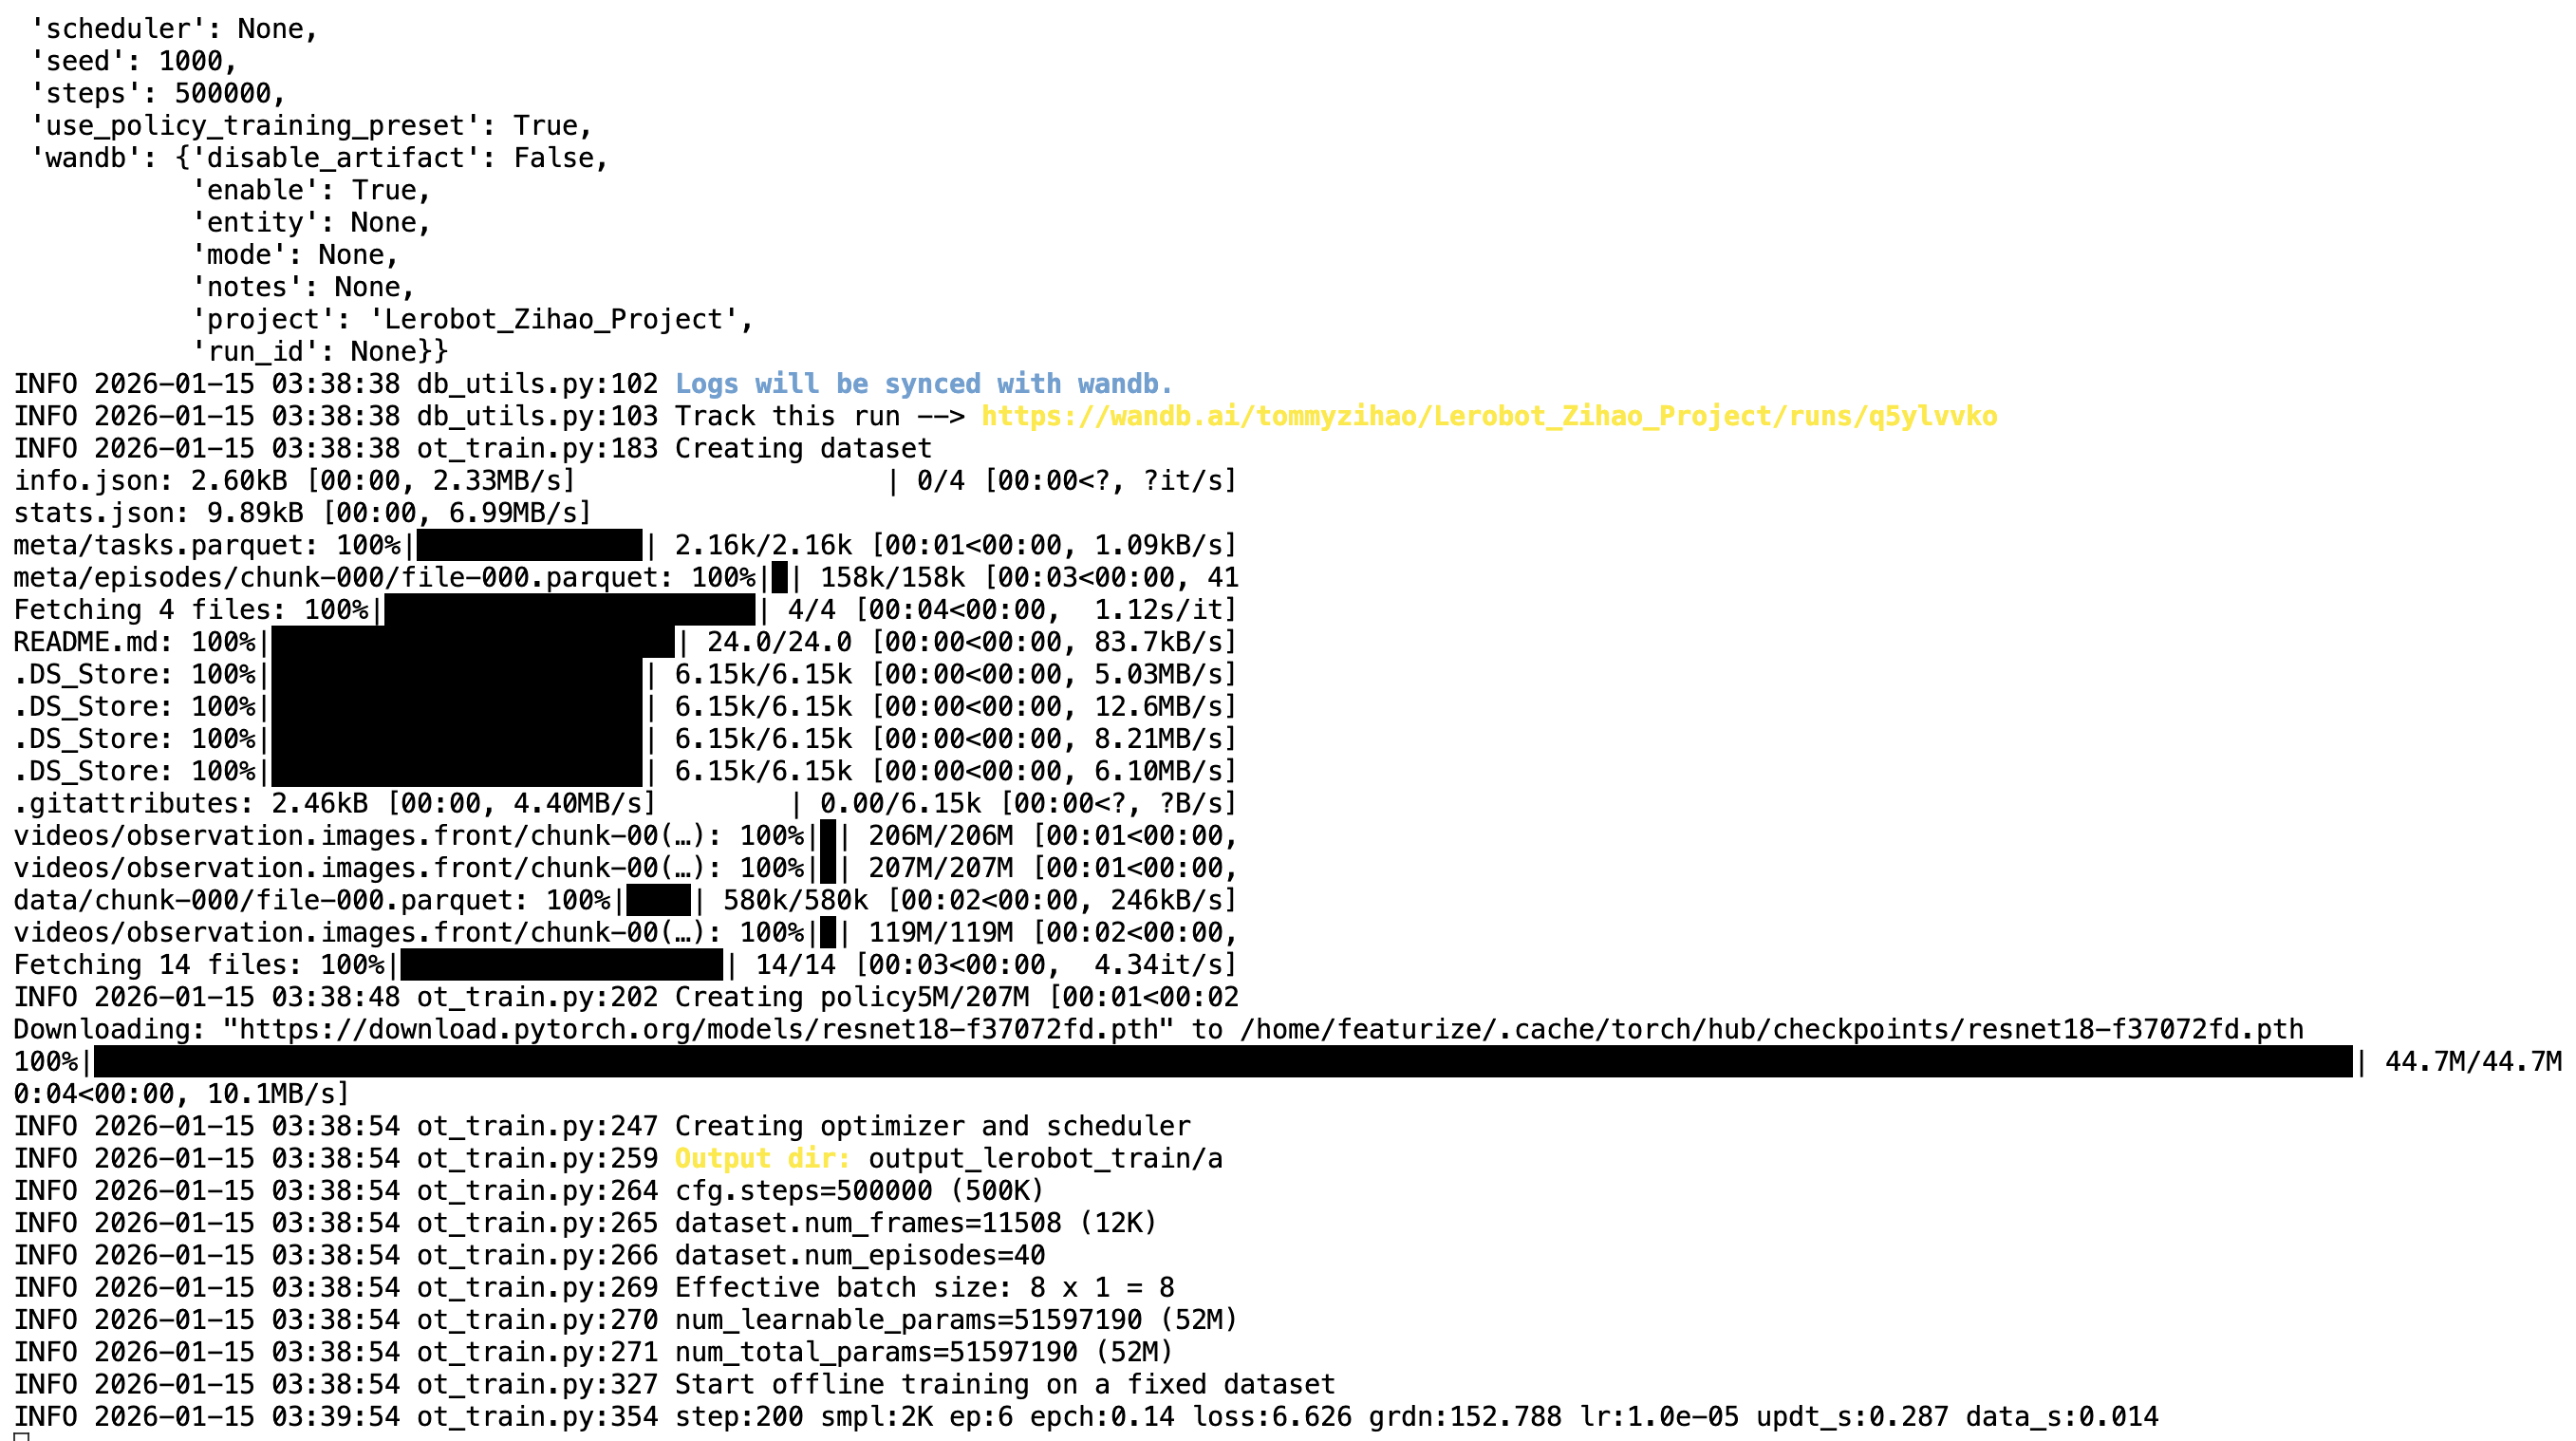
训练过程
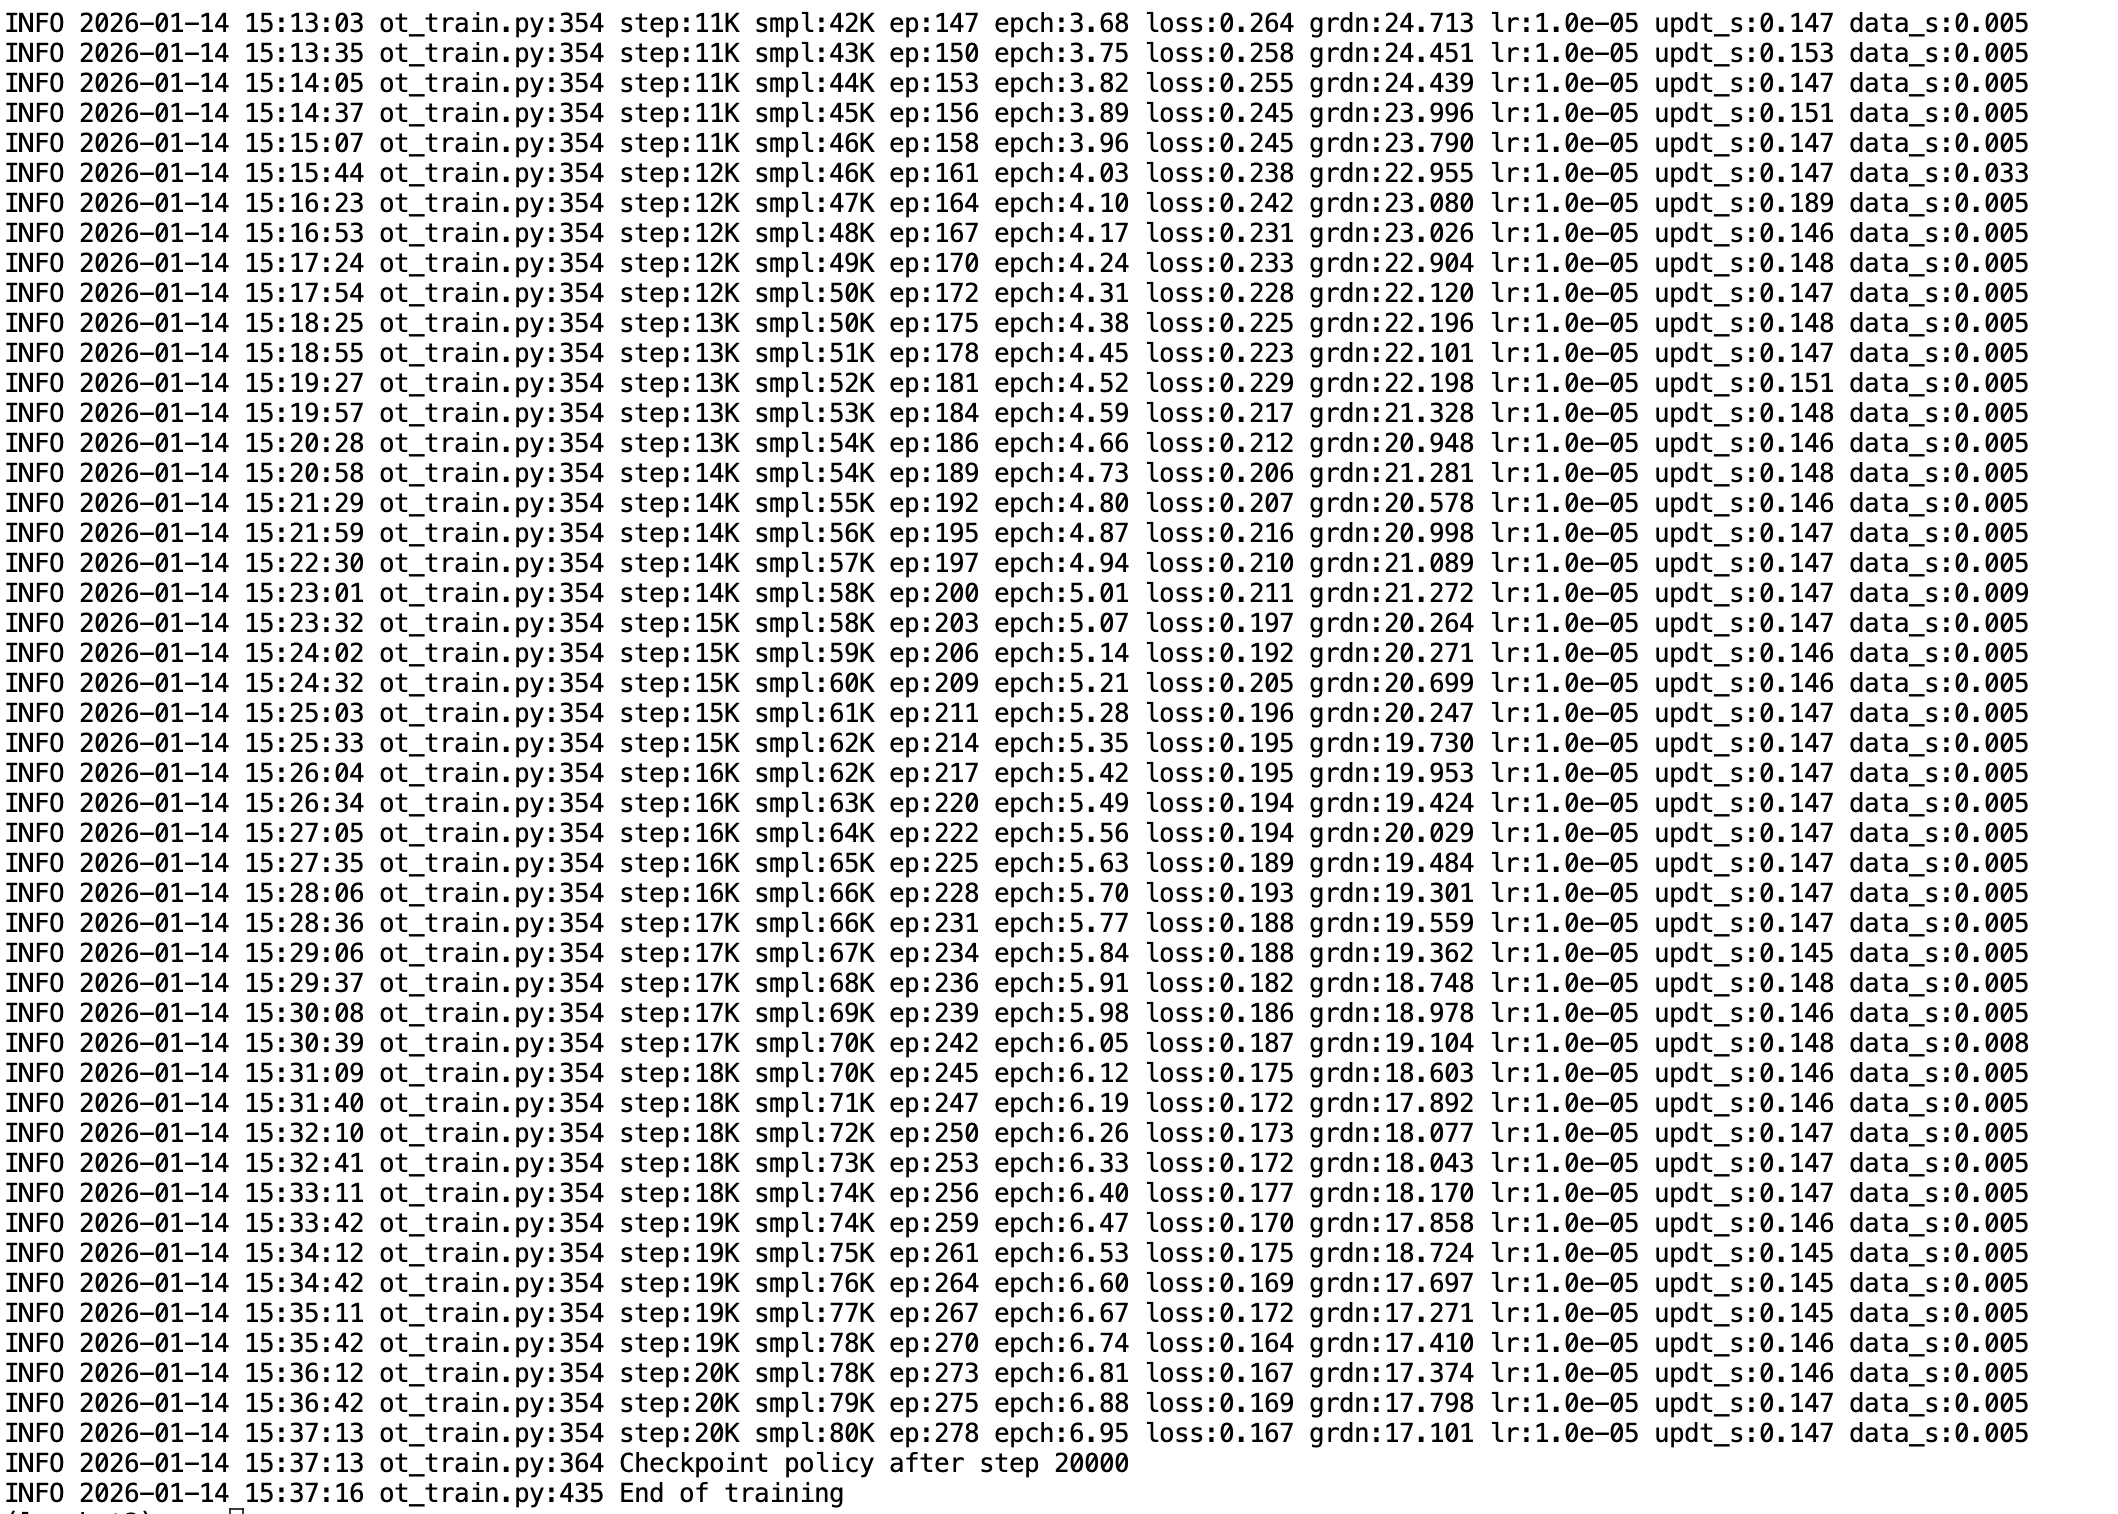
模型压缩包大概300MB