

7단계: ACT 학습 커맨드라인
실행 전
- 환경: 먼저 클라우드 GPU 학습 환경 설정에 따라 환경을 설치하고 dataset을 클라우드 GPU로 전송해야 합니다. ACT는 LeRobot 기본 환경에 포함되어 있어 추가 설치가 필요 없습니다
- dataset: 커맨드의
--dataset.root=~/lerobot_my_dataset_shake_hands는 6단계에서 수집한 악수 dataset을 가리킵니다. 자신의 작업을 학습한다면 자신의 dataset 이름으로 바꿔 주세요 - 출력 디렉터리:
--output_dir이 이미 존재하면 곧바로FileExistsError가 발생합니다. 새 디렉터리 이름으로 바꾸거나--resume=true를 추가해 학습을 이어 가세요 - 학습 중 언제든 wandb에서 곡선을 볼 수 있습니다, wandb 실시간 학습 곡선 확인을 참고하세요
참고 문서
https://github.com/huggingface/lerobot/blob/main/src/lerobot/scripts/lerobot_train.py
https://github.com/huggingface/lerobot/blob/main/src/lerobot/configs/train.py
왜 ACT 알고리즘부터 시작하는가
ACT는 LeRobot을 다룰 때 가장 먼저 학습하도록 권장하는 모델이며, 그 장점은 다음과 같습니다:
모델이 매우 가벼워 학습 가능한 파라미터가 8천만 개뿐입니다
학습 수렴 속도가 매우 빠르고, 추론 속도도 빠릅니다
GPU 1장에서 한 시간만 학습하면 효과를 볼 수 있습니다
ACT 모델 자체가 작아 압축 파일이 약 200MB 정도로, 저장과 전송이 매우 편리합니다. 학습으로 나온 모델 압축 파일은 약 300MB입니다(이 문서 끝 참고)
dataset은 30 라운드 데이터를 수집하면 기본적으로 충분합니다
Ubuntu 호스트, Mac 컴퓨터, Windows 컴퓨터, 심지어 Raspberry Pi에서도 배포하여 추론할 수 있습니다
실제 로봇에서의 추론 효과가 꽤 좋아, 집기, 악수, 펜 놓기 같은 간단한 작업에는 충분합니다
LeRobot 라이브러리의 기본 환경에 ACT 알고리즘이 이미 포함되어 있어 다른 라이브러리를 설치할 필요가 없습니다
커맨드라인
Shell
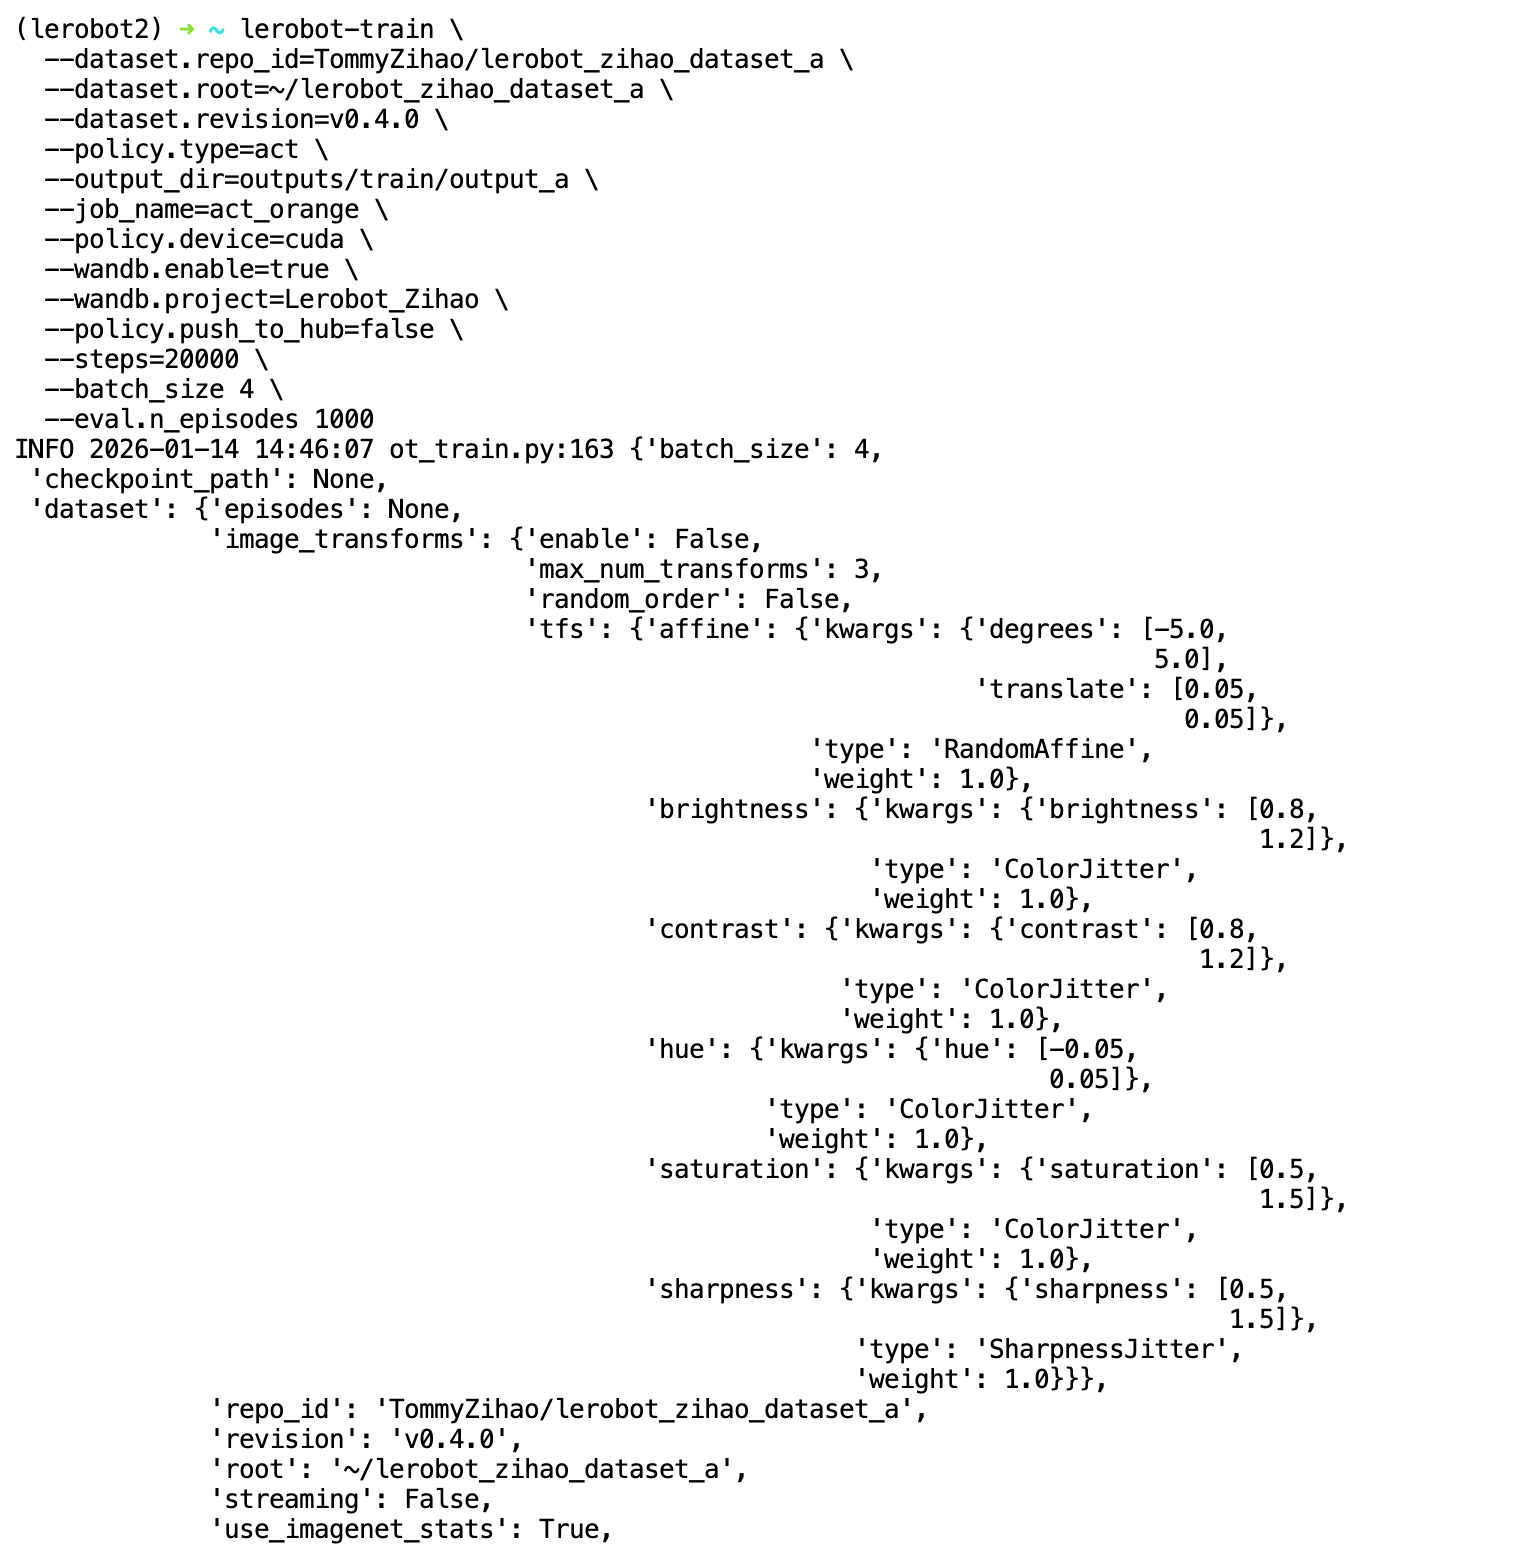
lerobot-train \
  --dataset.repo_id=<사용자명>/lerobot_my_dataset_shake_hands \
  --dataset.root=~/lerobot_my_dataset_shake_hands \
  --dataset.revision=v0.1.0 \
  --dataset.streaming=false \
  --policy.type=act \
  --output_dir=~/output_lerobot_train/shake/act/ \
  --job_name=shake_act_a \
  --policy.device=cuda \
  --wandb.enable=true \
  --wandb.project=Lerobot_my_Project \
  --policy.push_to_hub=false \
  --steps=20000 \
  --batch_size=8
커맨드라인 설명
줄바꿈 문자 `` 앞에는 공백이 하나만 있어야 하고, 뒤에는 공백이 없어야 합니다
| 커맨드라인 파라미터 | 설명 |
|---|---|
| --dataset.repo_id | HuggingFace dataset의 Repo_ID이며, 사용자 이름/dataset 이름 형태입니다 |
| --dataset.root | dataset의 로컬 경로입니다. dataset이 이미 로컬로 다운로드되어 있으면 실제 디렉터리를 가리켜야 합니다 |
| --dataset.revision | dataset 버전으로, dataset을 HuggingFace에 업로드할 때 지정한 값입니다 |
| --dataset.streaming | 스트리밍 읽기 여부입니다. dataset이 로컬에 있으면 false로 설정하며, 스트리밍 읽기가 필요 없습니다 |
| --policy.type | 학습할 알고리즘으로, 예를 들어 act, smolvla, diffusion, pi0, pi05, pi0_fast, wall_x입니다 |
| --output_dir | 학습 출력이 저장되는 디렉터리입니다 |
| --job_name | 이번 학습 작업의 이름입니다 |
| --policy.device | 계산 장치입니다 |
| --wandb.enable | wandb 시각화를 켭니다 |
| --wandb.project | wandb 프로젝트 이름입니다 |
| --policy.push_to_hub | 학습한 모델을 HuggingFace 클라우드로 전송합니다 |
| --steps | 학습 step 수입니다 |
| --batch_size | 한 step에 입력하는 데이터 양으로, VRAM이 부족하면 줄여야 합니다 |
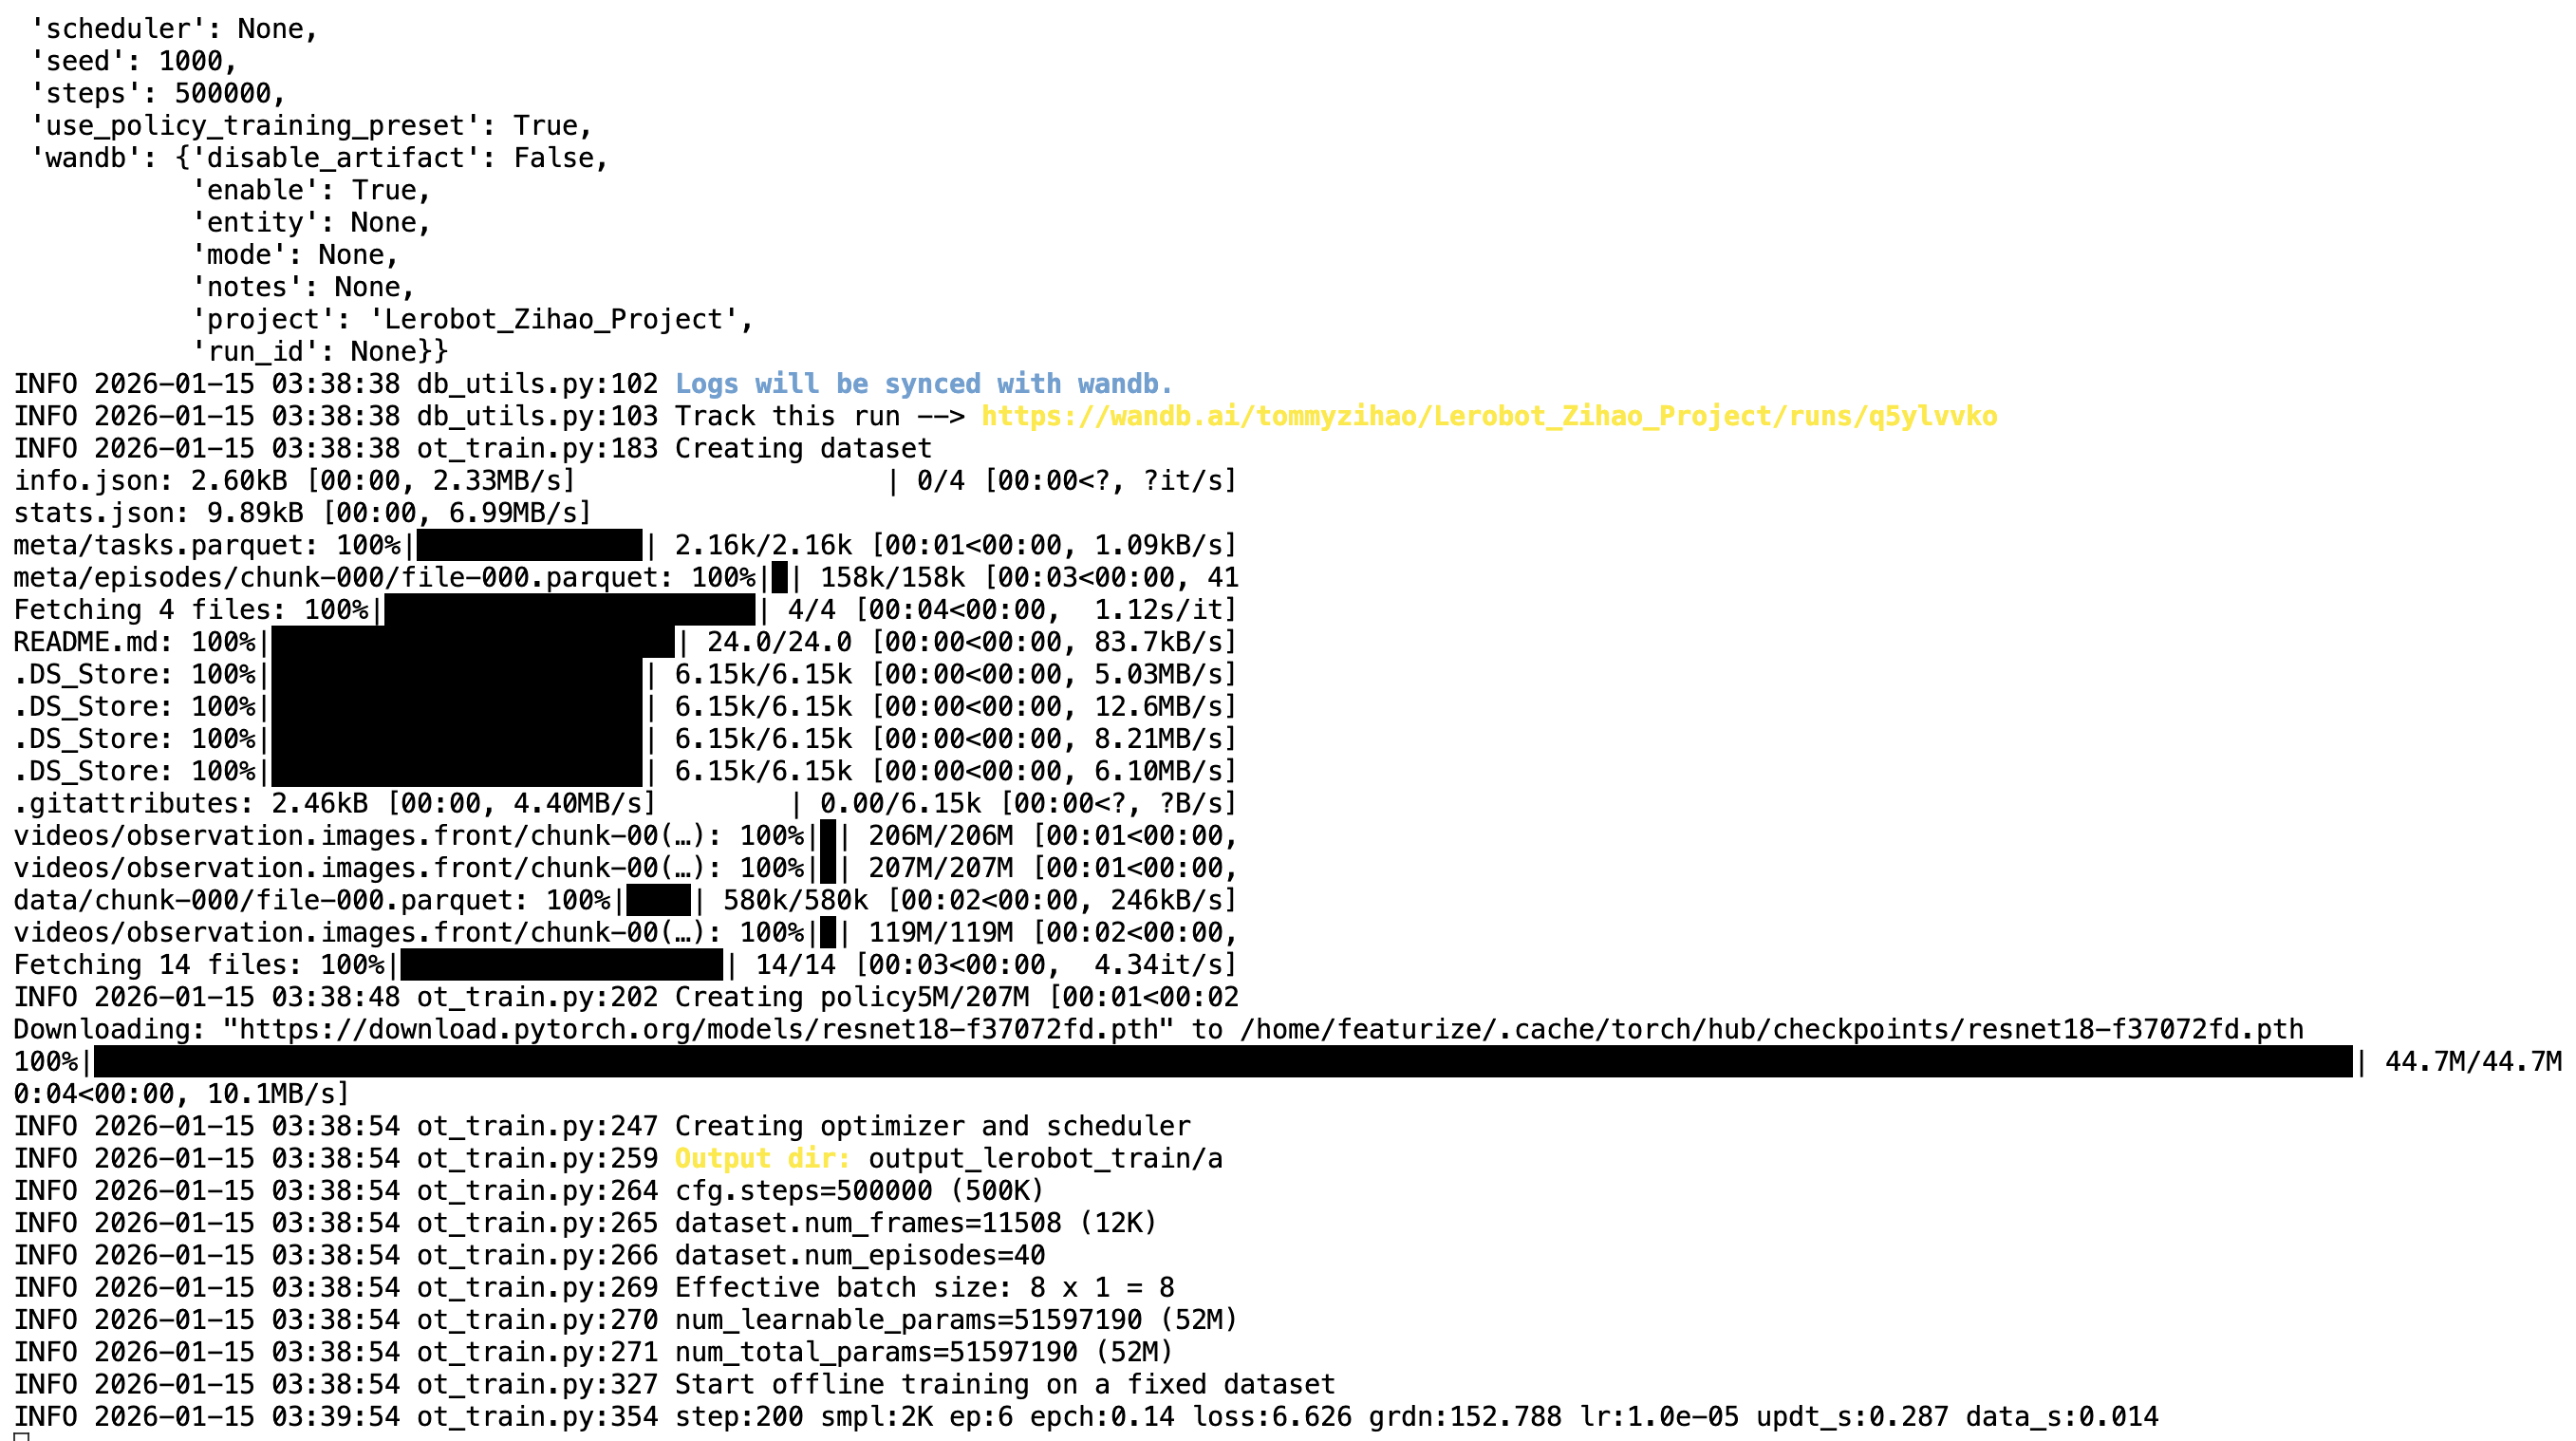
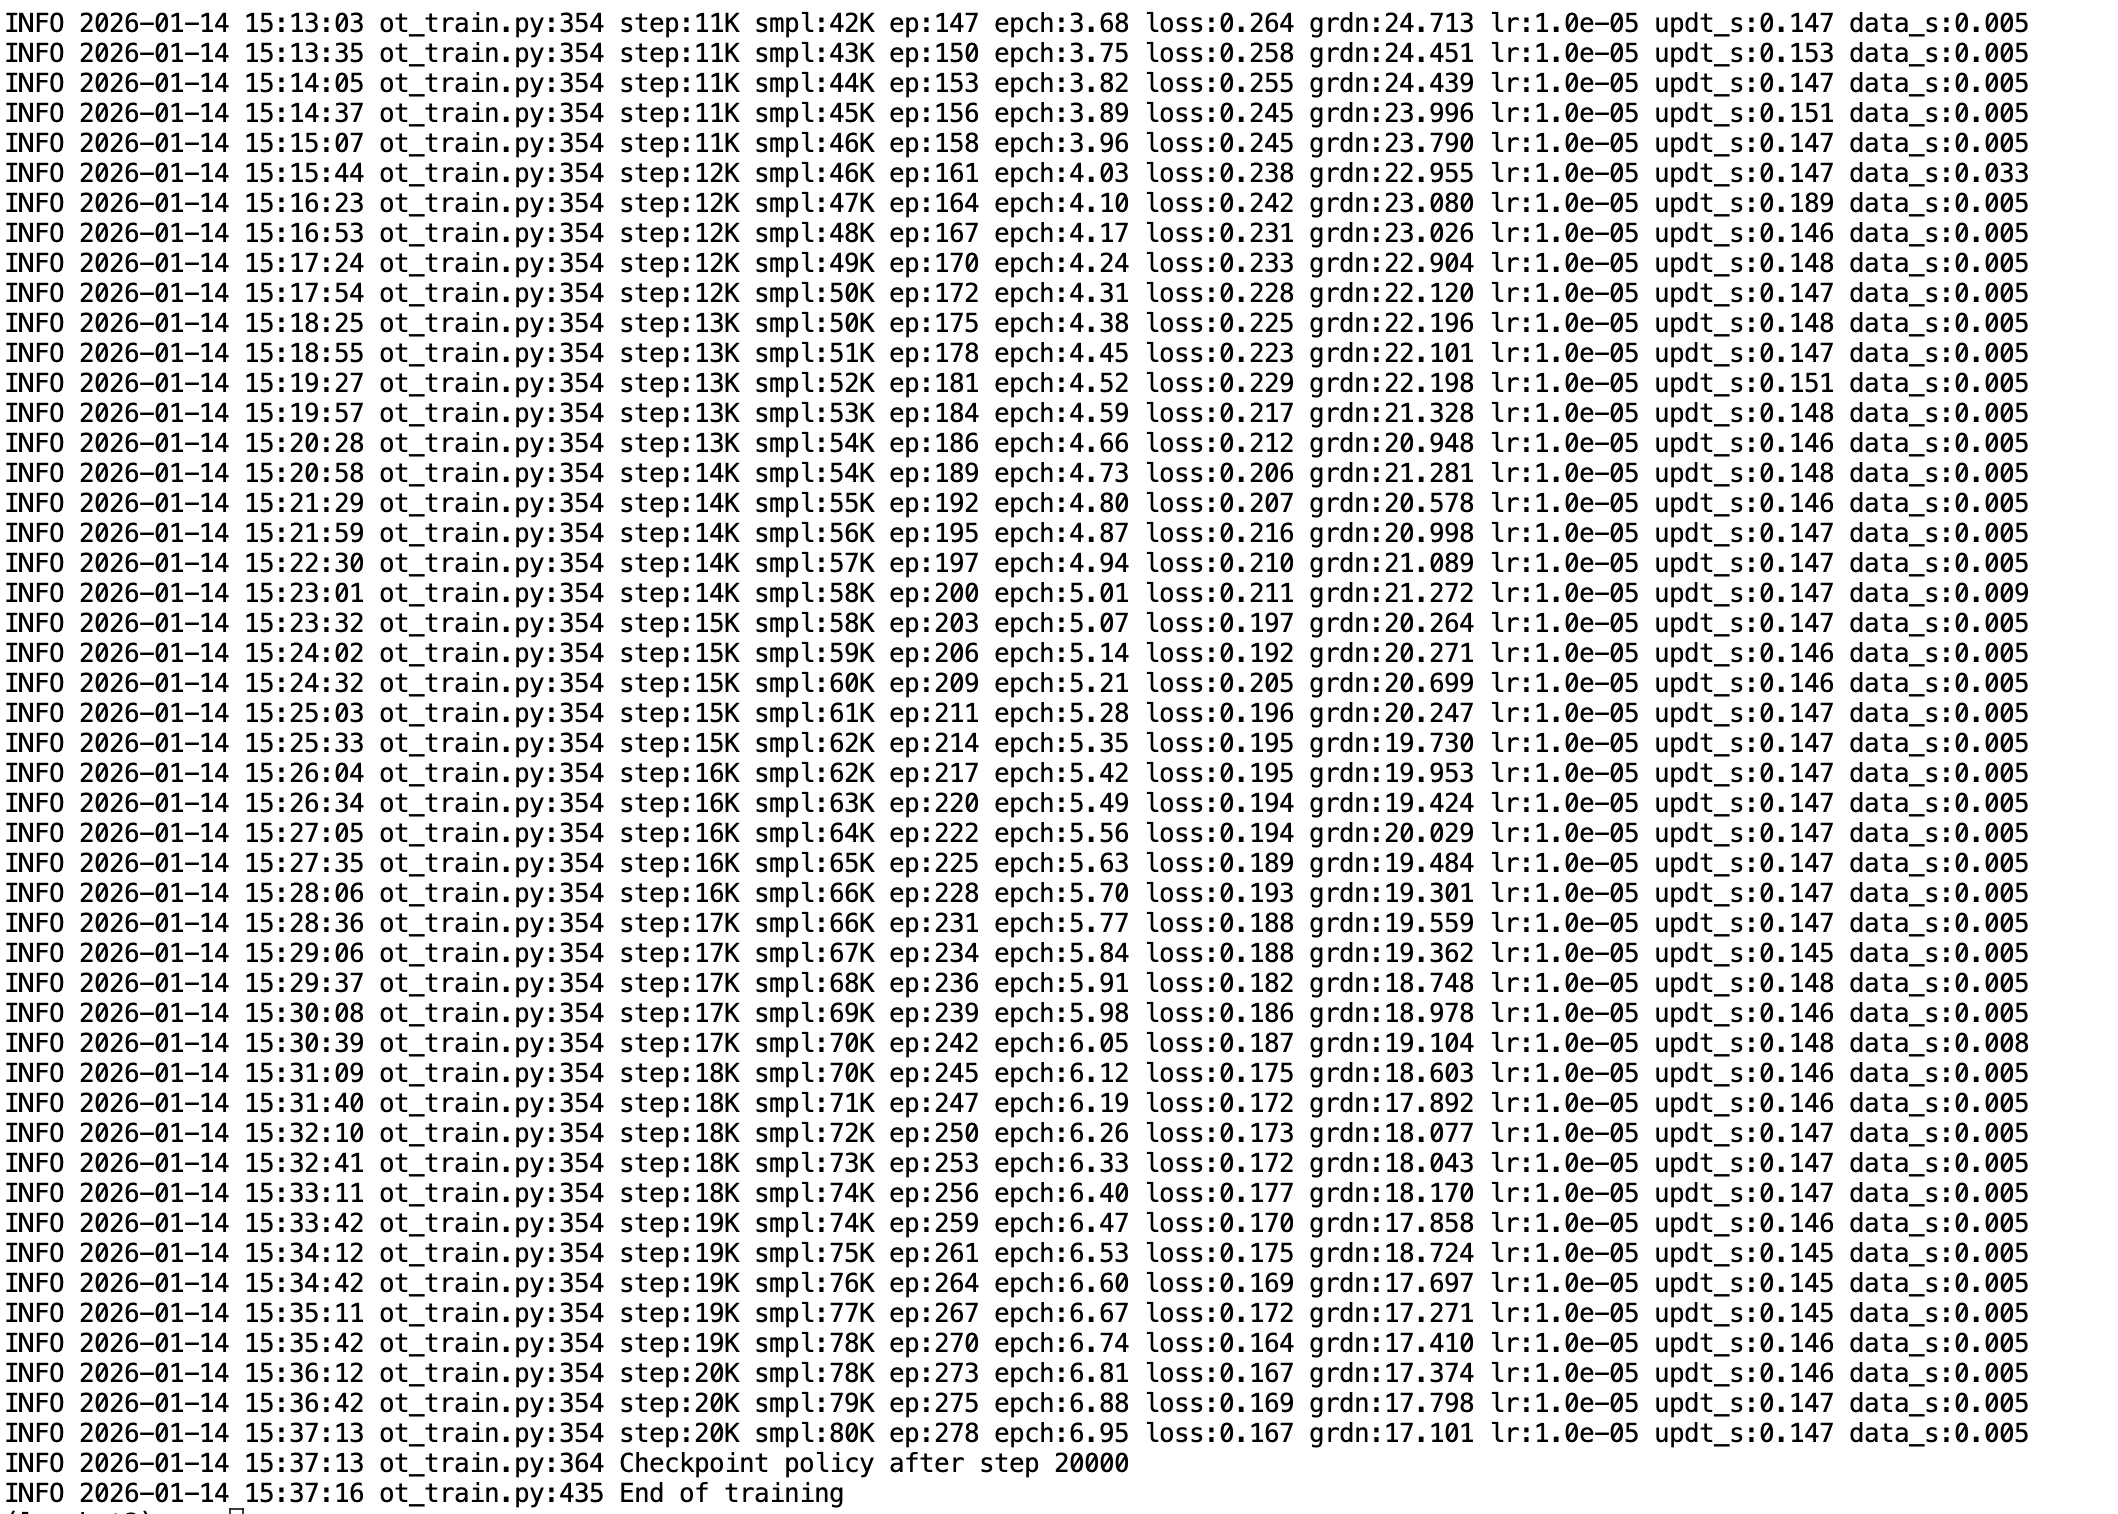
학습 과정
모델 압축 파일은 약 300MB입니다