

ステップ7:訓練コマンドライン-ACT
実行の前に
- 環境:まずクラウドGPU訓練環境の設定に従って環境をインストールし、データセットをクラウドGPUに転送する必要があります。ACT は LeRobot の基本環境に最初から含まれているため、追加インストールは不要です
- データセット:コマンド内の
--dataset.root=~/lerobot_my_dataset_shake_handsはステップ6で収集した握手データセットを指します。自分で収集したタスクを訓練する場合は、自分のデータセット名に置き換えてください - 出力ディレクトリ:
--output_dirがすでに存在する場合は、そのままFileExistsErrorが報告されます。新しいディレクトリ名に変更するか、--resume=trueを追加して訓練を続行してください - 訓練中はいつでも wandb で曲線を確認できます。wandbでリアルタイム訓練曲線を確認を参照してください
参考ドキュメント
https://github.com/huggingface/lerobot/blob/main/src/lerobot/scripts/lerobot_train.py
https://github.com/huggingface/lerobot/blob/main/src/lerobot/configs/train.py
なぜACTアルゴリズムから始めるのか
ACTはLeRobotを扱う上で最初に訓練することが最も推奨されるモデルです。そのメリットは以下のとおりです:
モデルが非常に軽量で、学習可能なパラメータがわずか8000万個です
訓練の収束が非常に速く、推論速度も速いです
シングルGPUで1時間訓練すれば効果が確認できます
ACTモデル自体が小さく、圧縮パッケージはおよそ200MB程度で、保存と転送が非常に便利です。訓練で生成されるモデルの圧縮パッケージは約300MBです(本記事の末尾を参照)
データセットは30回のデータ収集でほぼ十分です
Ubuntu ホスト、Mac、Windows パソコン、さらには Raspberry Pi 上でもデプロイして推論できます
実機ロボットでの推論効果もかなり良く、掴み取り、握手、ペン置きといった簡単なタスクには十分です
LeRobot ライブラリの基本環境にはすでに ACT アルゴリズムが含まれており、他のライブラリをインストールする必要はありません
コマンドライン
Shell
lerobot-train \
  --dataset.repo_id=<ユーザー名>/lerobot_my_dataset_shake_hands \
  --dataset.root=~/lerobot_my_dataset_shake_hands \
  --dataset.revision=v0.1.0 \
  --dataset.streaming=false \
  --policy.type=act \
  --output_dir=~/output_lerobot_train/shake/act/ \
  --job_name=shake_act_a \
  --policy.device=cuda \
  --wandb.enable=true \
  --wandb.project=Lerobot_my_Project \
  --policy.push_to_hub=false \
  --steps=20000 \
  --batch_size=8
コマンドラインの説明
改行文字``の前には半角スペースを1つだけ、後ろにはスペースを入れてはいけません
| コマンドラインパラメータ | 説明 |
|---|---|
| --dataset.repo_id | HuggingFace データセットの Repo_ID。用户名/数据集名 の形式 |
| --dataset.root | データセットのローカルパス。データセットがすでにローカルにダウンロードされている場合は、実際のディレクトリを指す必要があります |
| --dataset.revision | データセットのバージョン。HuggingFace にデータセットをアップロードした際に指定したものです |
| --dataset.streaming | ストリーミング読み込みを行うかどうか。データセットがローカルにある場合はfalseに設定します。ストリーミング読み込みが不要だからです |
| --policy.type | 訓練するアルゴリズム。例えば act、smolvla、diffusion、pi0、pi05、pi0_fast、wall_x |
| --output_dir | 訓練出力を保存するディレクトリ |
| --job_name | 今回の訓練タスクの名前 |
| --policy.device | 計算デバイス |
| --wandb.enable | wandb の可視化を有効にする |
| --wandb.project | wandb のプロジェクト名 |
| --policy.push_to_hub | 訓練したモデルを HuggingFace のクラウドにアップロードする |
| --steps | 訓練ステップ数 |
| --batch_size | 1ステップで入力するデータ量。VRAM が足りない場合は小さくする必要があります |
訓練プロセス
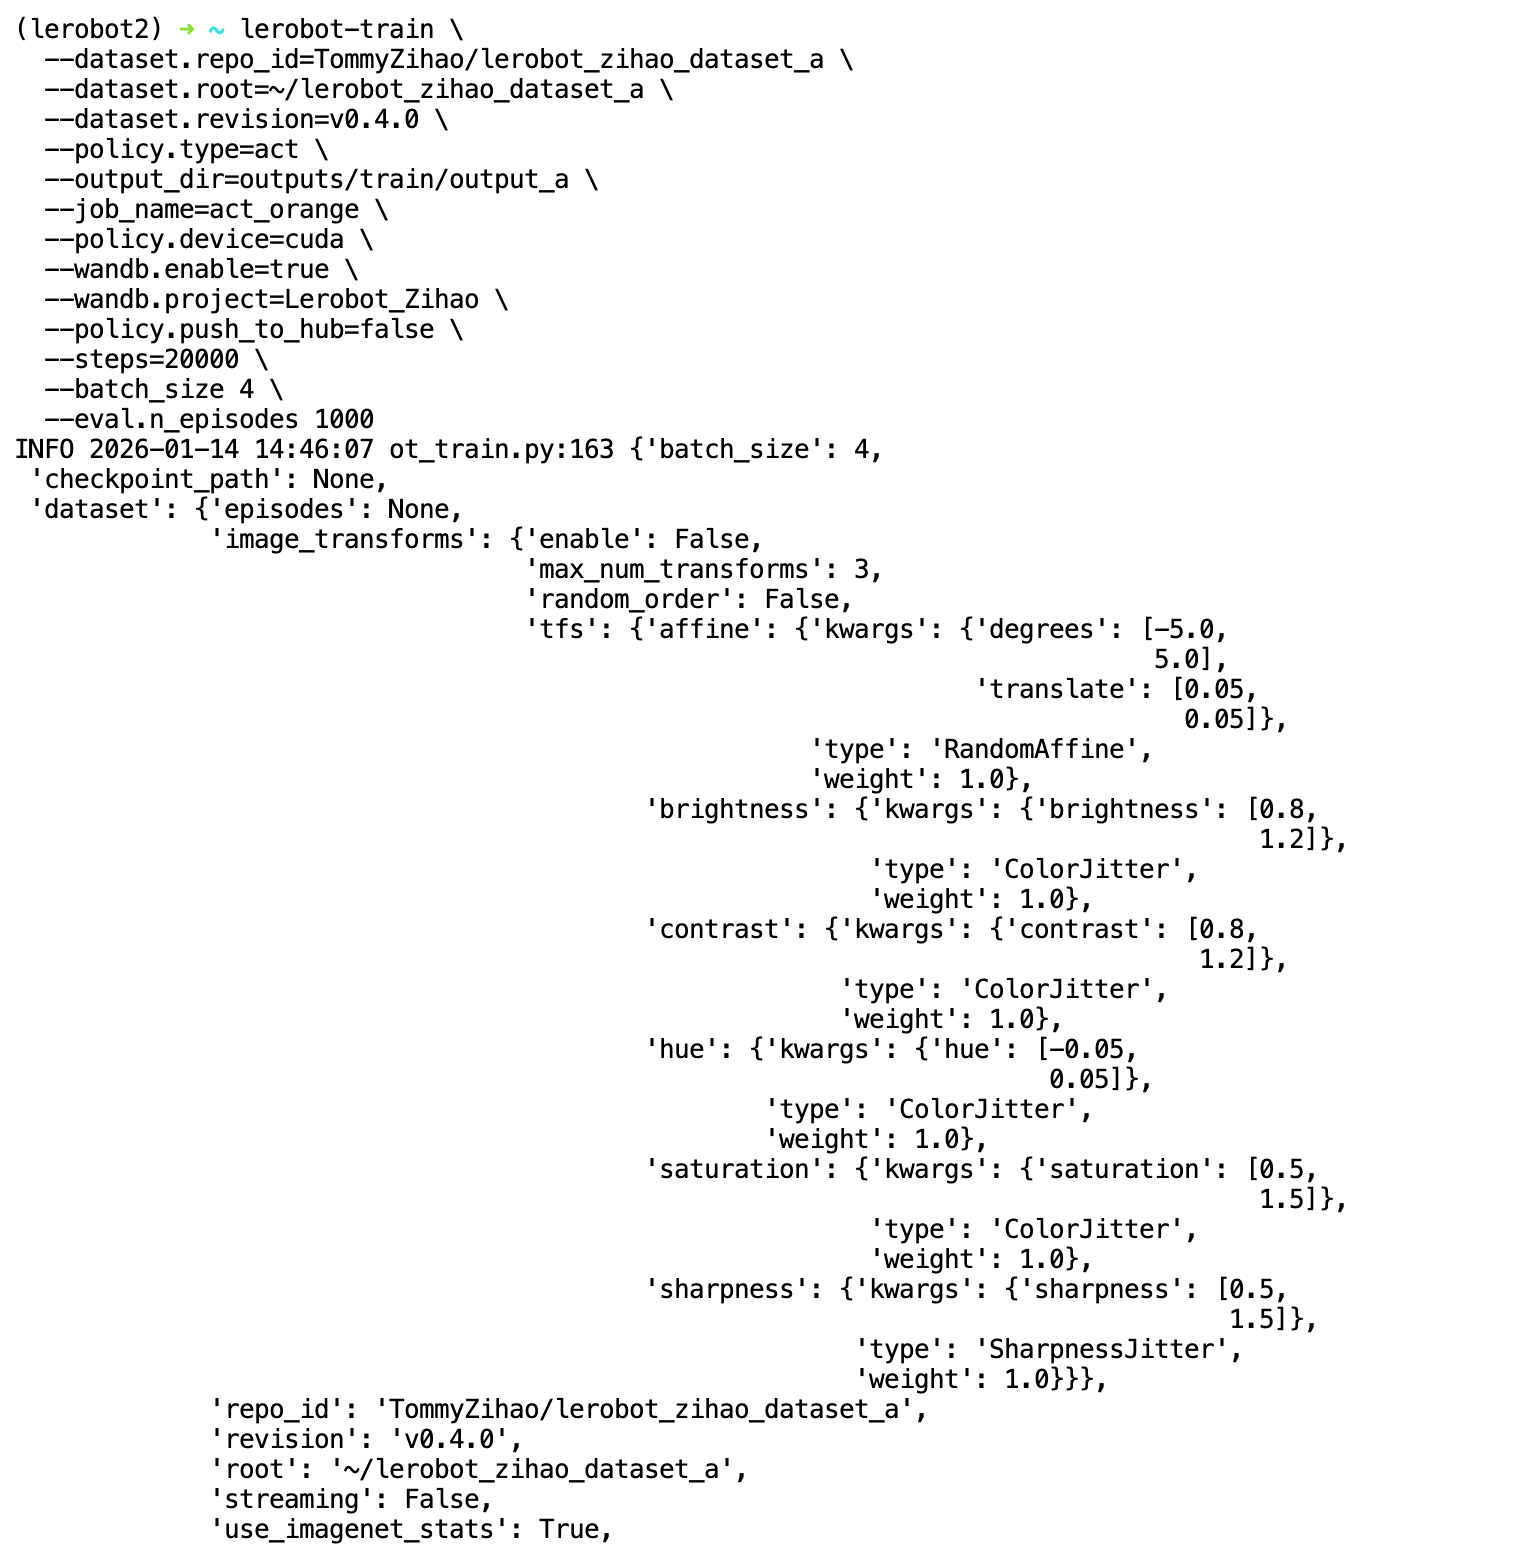
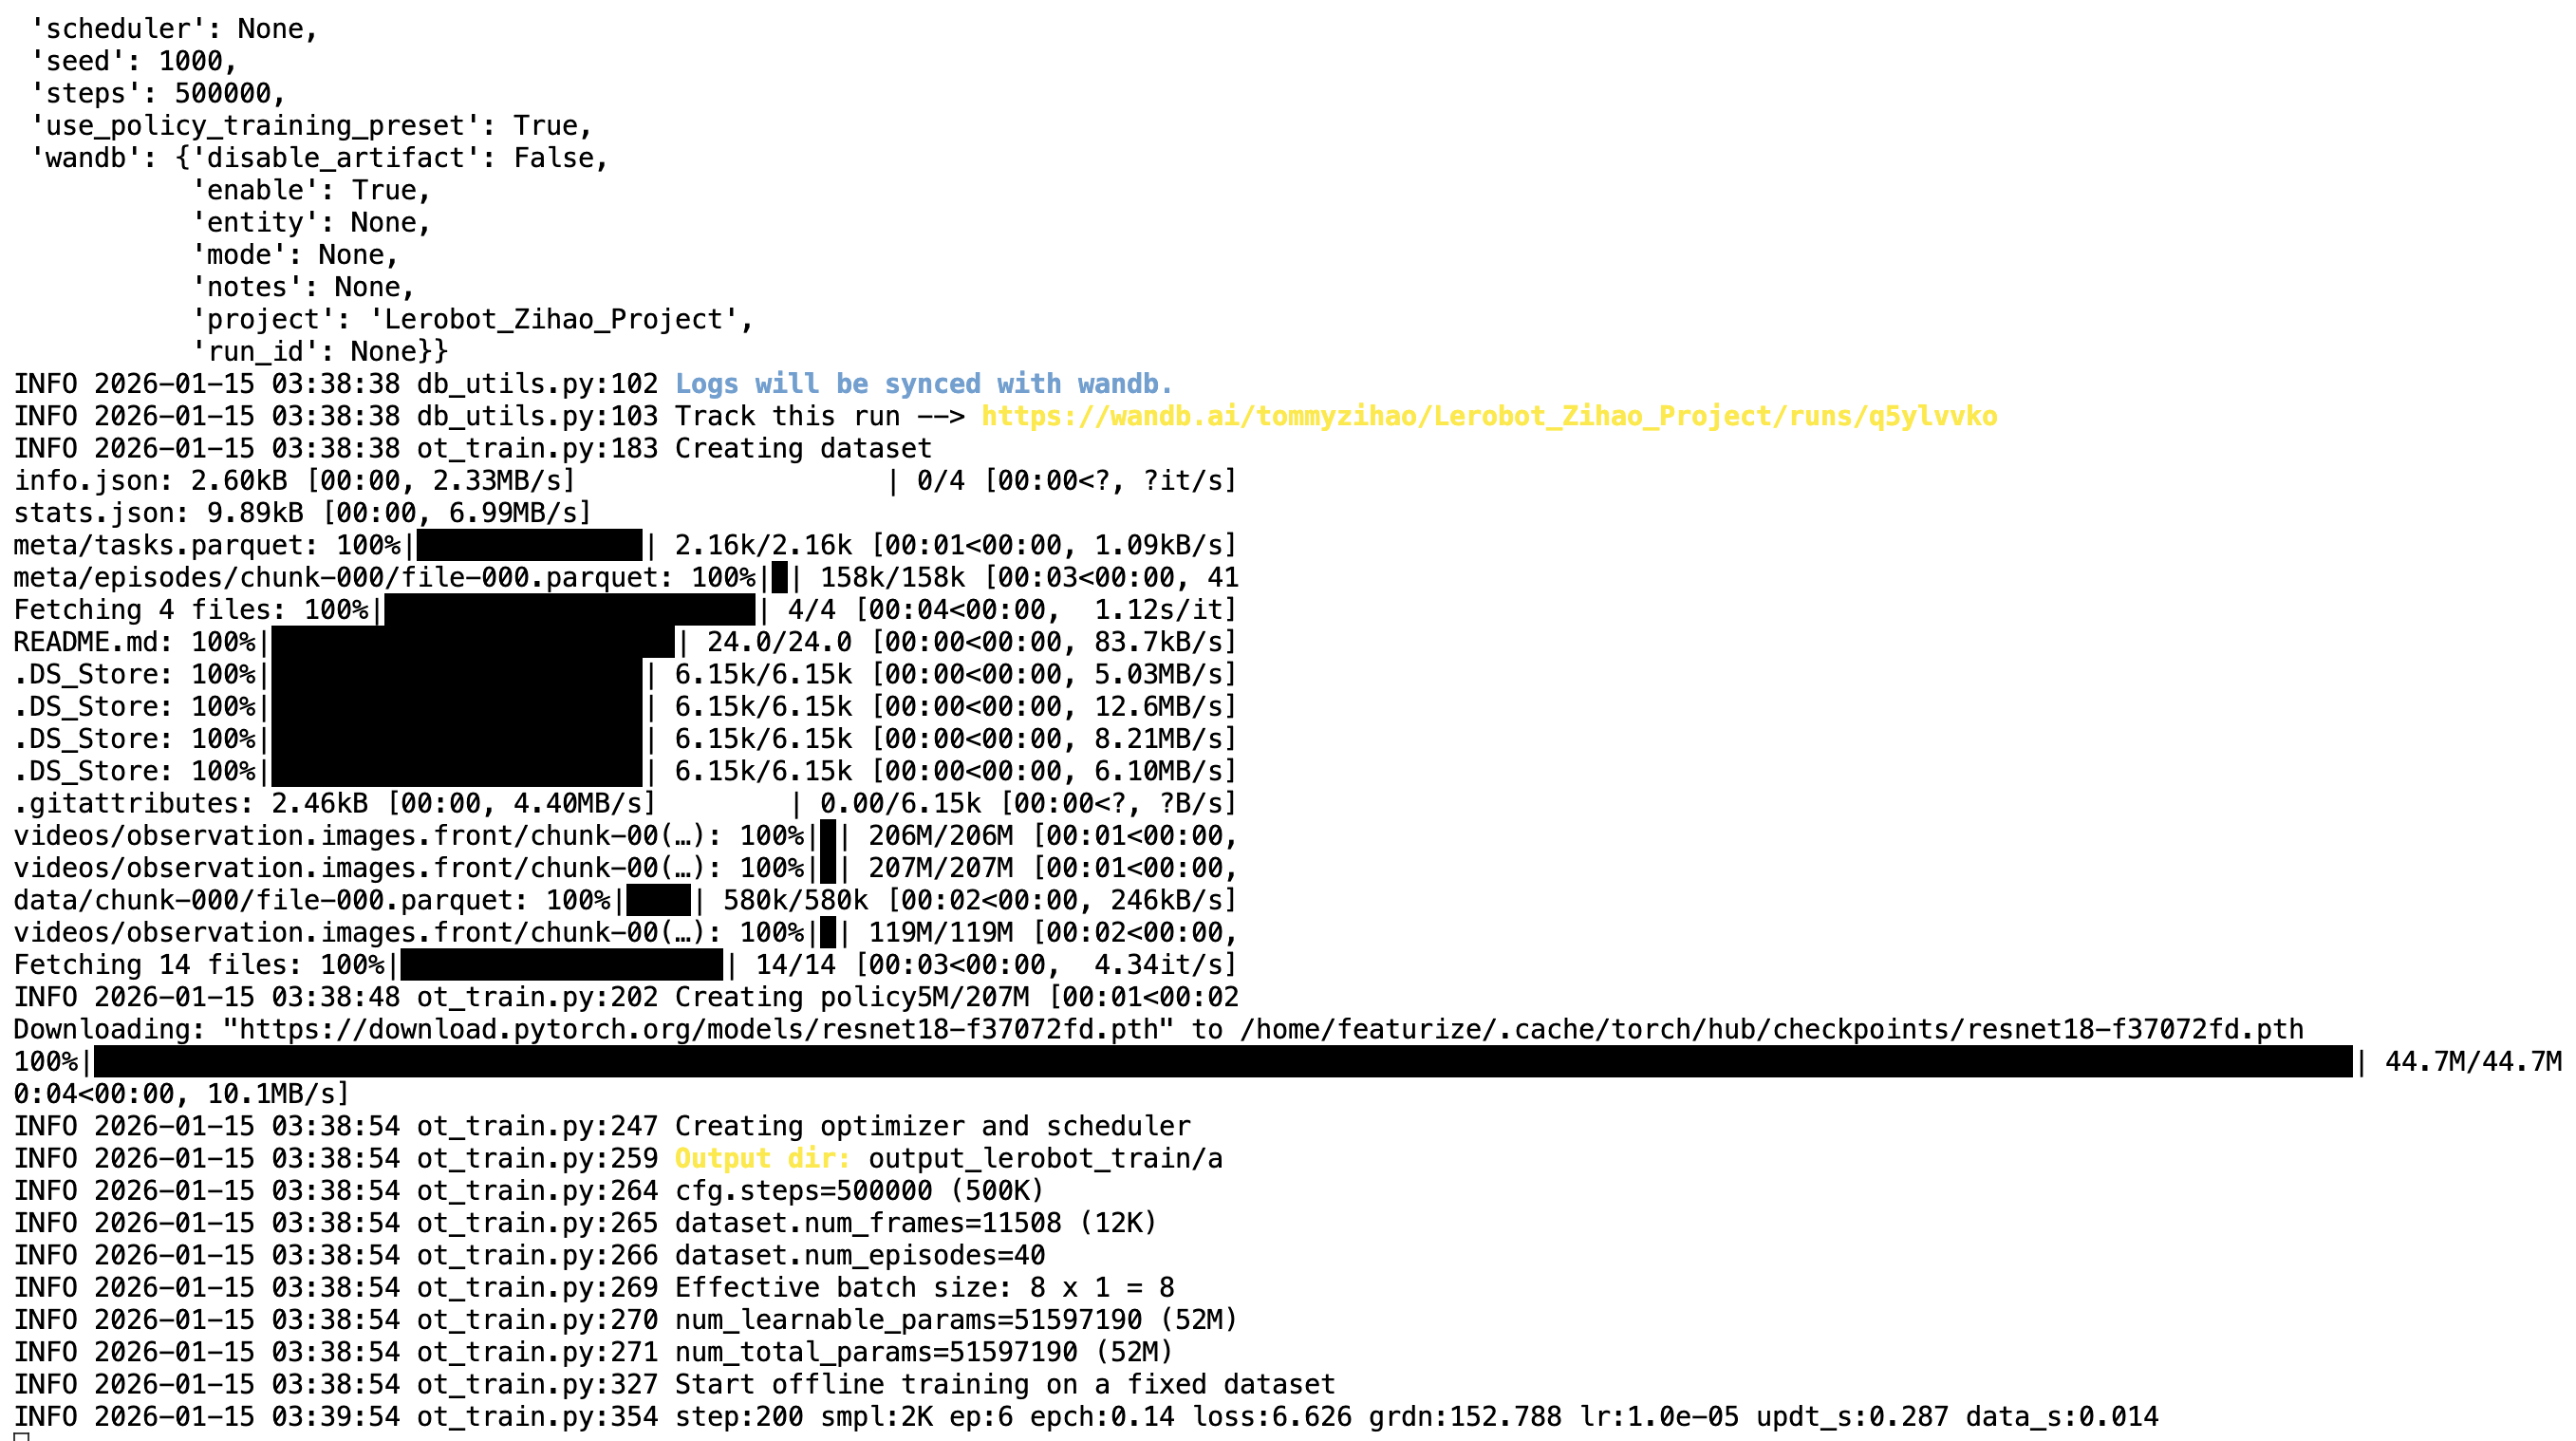
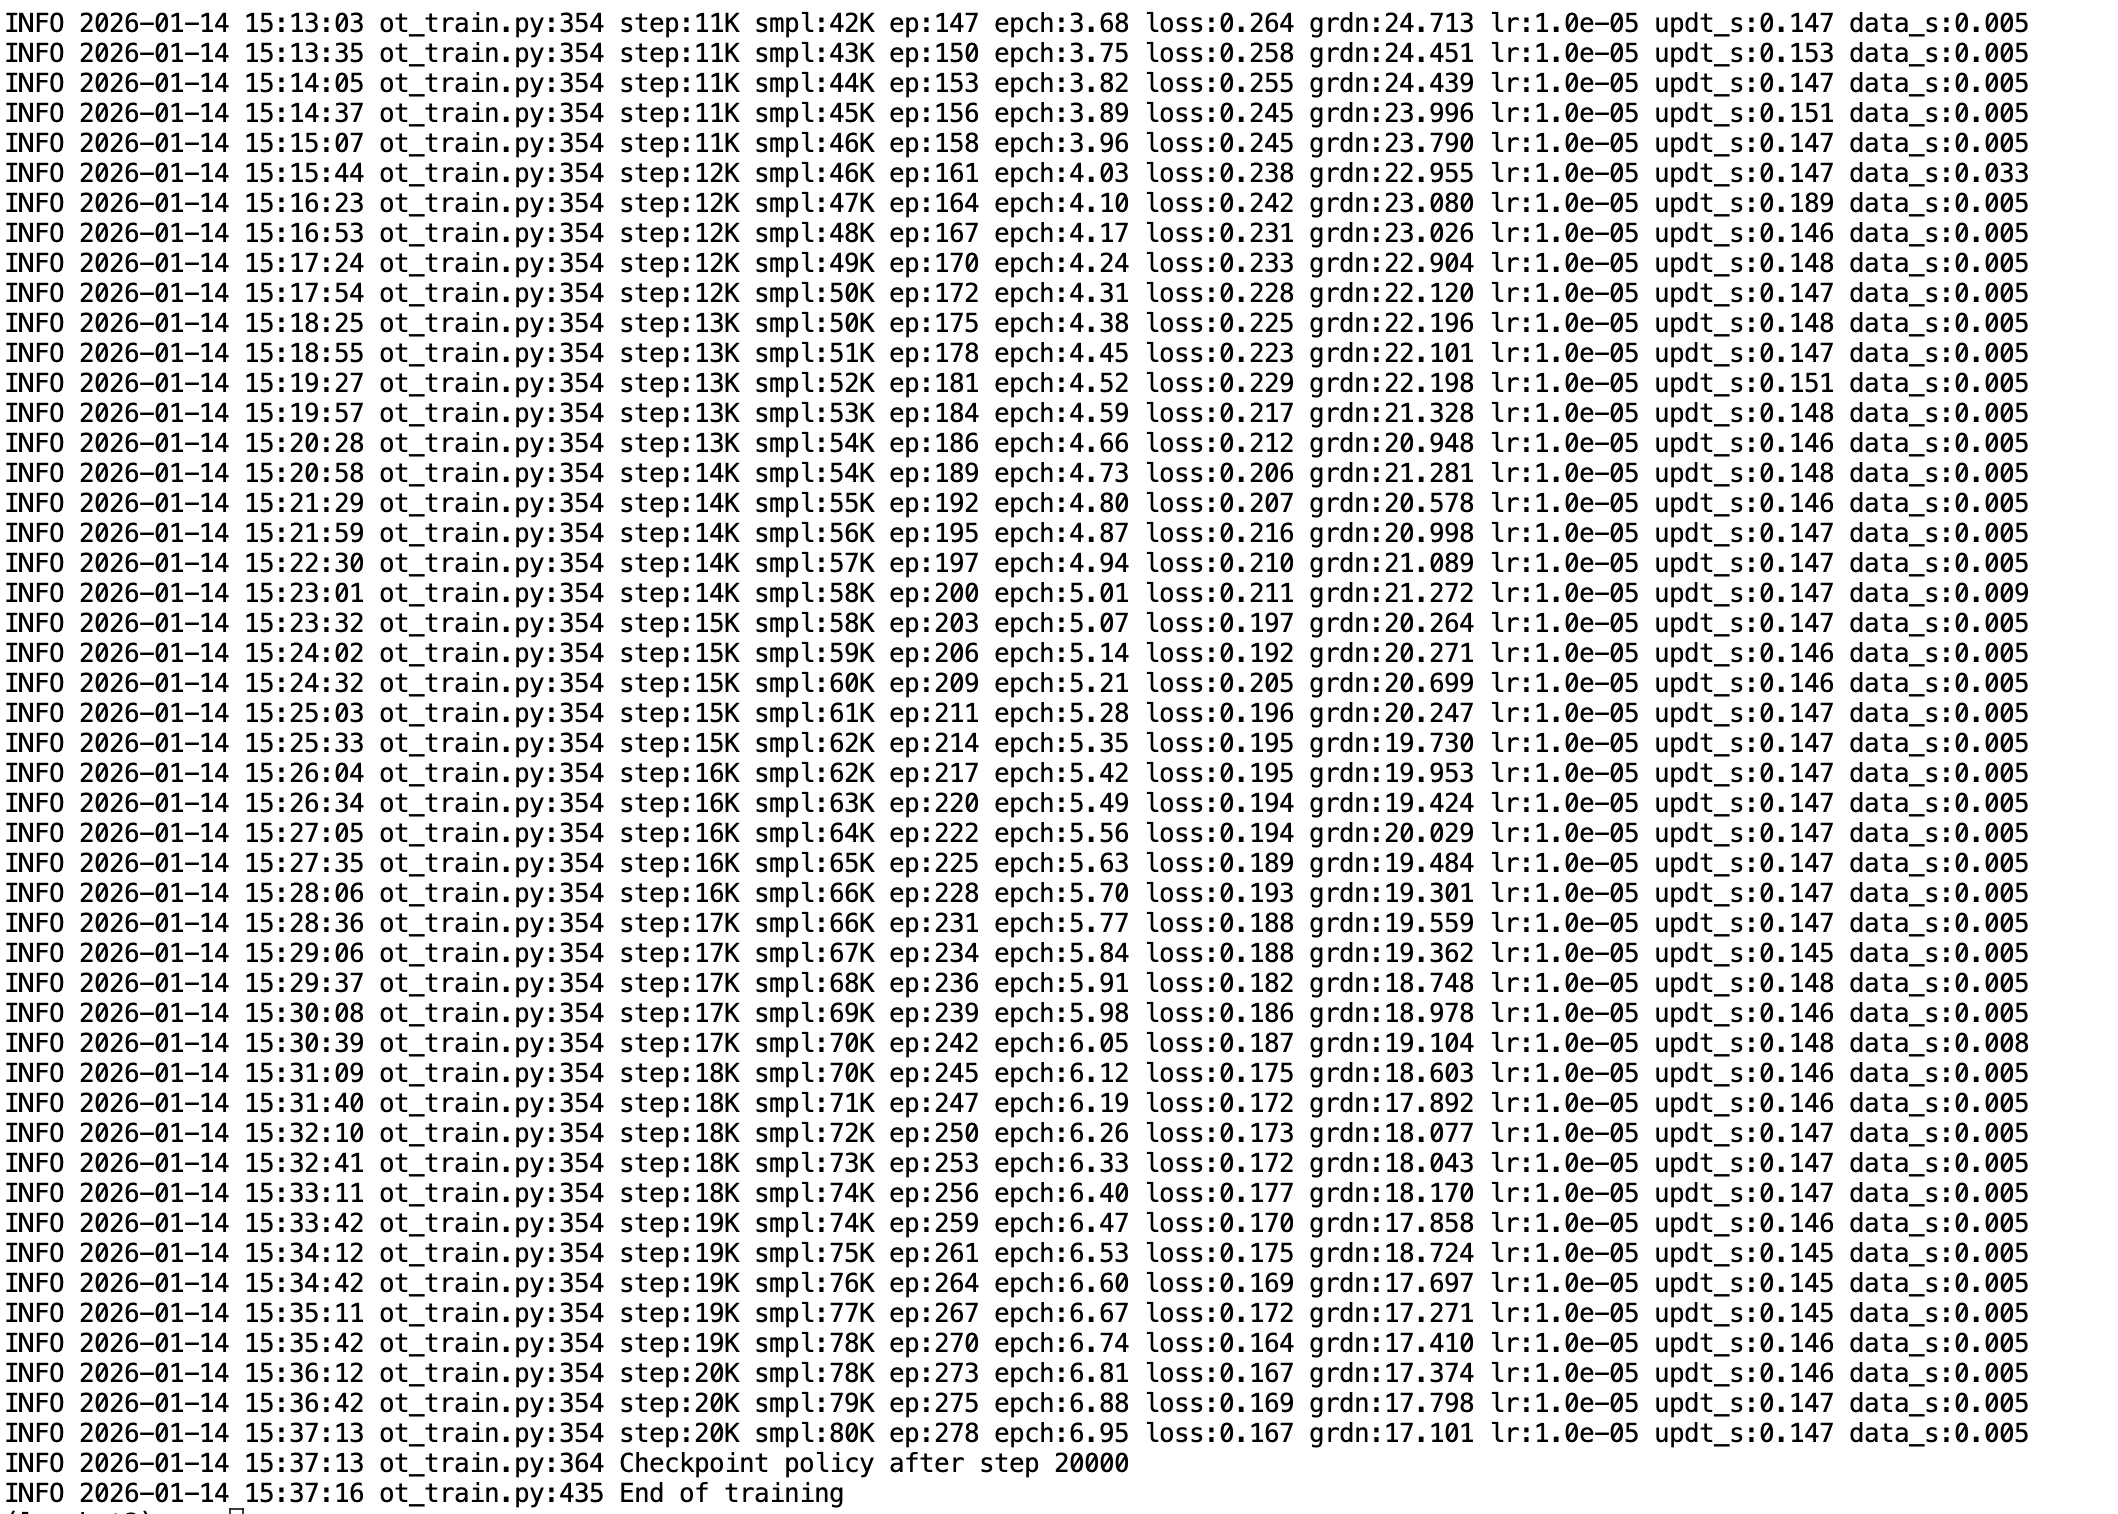
モデルの圧縮パッケージはおよそ300MBです