

Commande d'entraînement - ACT (recommandé pour débuter)
Documentation de référence
https://github.com/huggingface/lerobot/blob/46e19ae579f80ce66211afafd1c3c649c569131f/docs/source/act.mdx
https://github.com/huggingface/lerobot/blob/main/src/lerobot/scripts/lerobot_train.py
https://github.com/huggingface/lerobot/blob/main/src/lerobot/configs/train.py
Pourquoi commencer par l'algorithme ACT
ACT est le premier modèle le plus recommandé à entraîner pour débuter avec LeRobot ; voici ses avantages :
Le modèle est très léger, avec seulement quatre-vingts millions de paramètres apprenables
La convergence de l'entraînement est très rapide, et l'inférence aussi
Une heure d'entraînement sur un seul GPU suffit pour voir des résultats
L'archive de téléchargement du modèle ACT fait environ 200 Mo, ce qui le rend très facile à stocker et à transférer
Collecter environ 30 épisodes de données suffit généralement
Peut être déployé et exécuté en inférence sur un hôte Ubuntu, un ordinateur Mac, un ordinateur Windows, et même un Raspberry Pi
Les résultats d'inférence sur un robot réel sont plutôt bons, amplement suffisants pour des tâches simples comme saisir, serrer la main ou poser un stylo
L'environnement de base de la bibliothèque LeRobot inclut déjà l'algorithme ACT, aucune autre bibliothèque n'est à installer
Ligne de commande
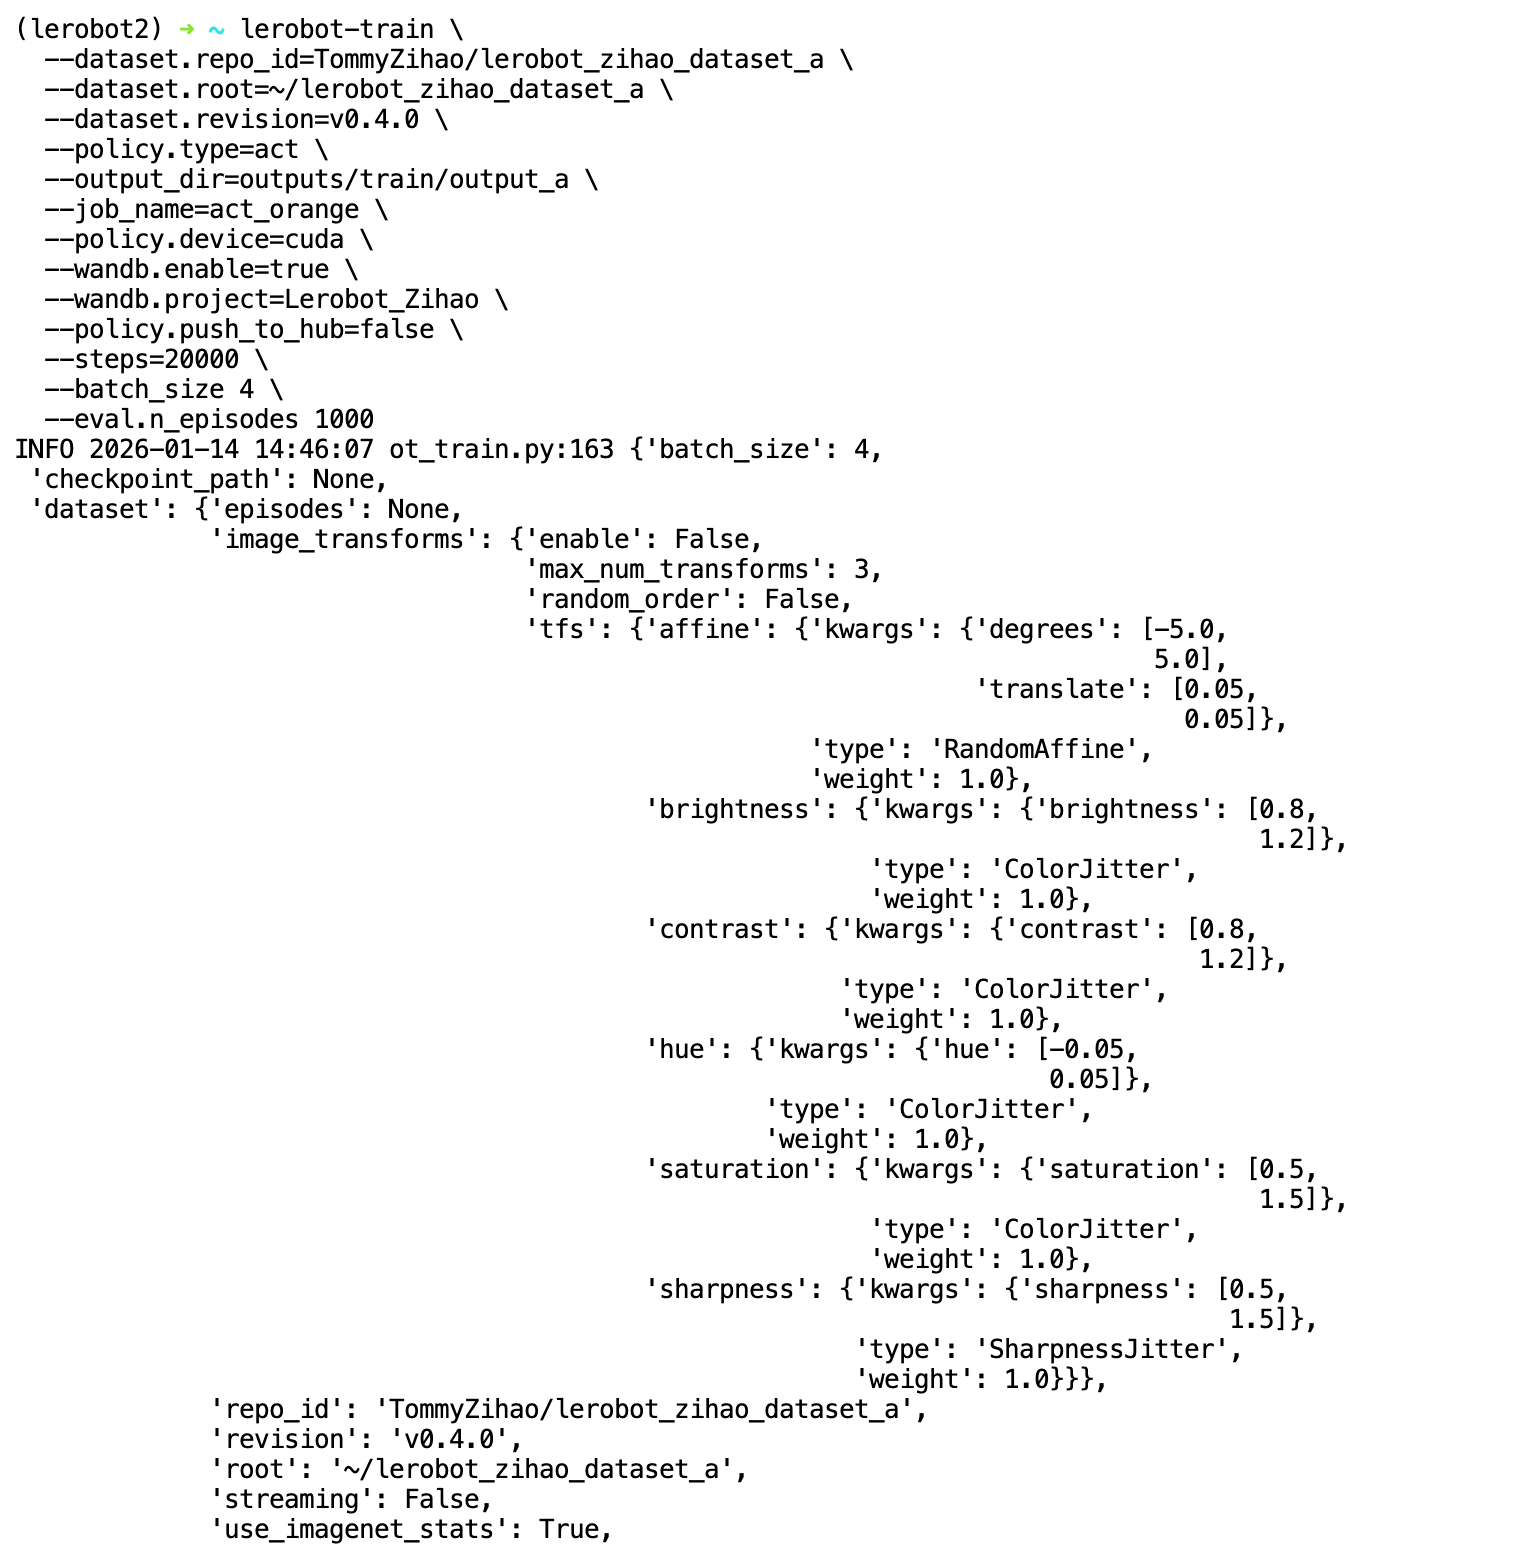
lerobot-train \
  --dataset.repo_id=Tommymy/lerobot_my_dataset_shake_hands \
  --dataset.root=~/lerobot_my_dataset_shake_hands \
  --dataset.revision=v0.1.0 \
  --dataset.streaming=false \
  --policy.type=act \
  --output_dir=~/output_lerobot_train/shake/act/ \
  --job_name=shake_act_a \
  --policy.device=cuda \
  --wandb.enable=true \
  --wandb.project=Lerobot_my_Project \
  --policy.push_to_hub=false \
  --steps=20000 \
  --batch_size=8
Description de la ligne de commande
Le caractère de continuation \ ne peut être précédé que d'un seul espace et ne doit être suivi d'aucun espace
Les paramètres en rouge sont ceux à vérifier ou à modifier avant chaque exécution
| Paramètre de ligne de commande | Description |
|---|---|
| --dataset.repo_id | Repo_ID du dataset HuggingFace |
| --dataset.root | Chemin local du dataset |
| --dataset.revision | Version du dataset, spécifiée lors du téléversement du dataset sur HuggingFace |
| --dataset.streaming | Le dataset étant en local, doit être false, car le dataset est déjà en local et la lecture en flux n'est pas nécessaire |
| --dataset.split | Par défaut train, c'est-à-dire utiliser toutes les données comme ensemble d'entraînement |
| --policy.type | Algorithme à entraîner, par exemple act, smolvla, diffusion, pi0, wallx |
| --output_dir | Répertoire où sont enregistrées les sorties de l'entraînement |
| --job_name | Nom de cette tâche d'entraînement |
| --policy.device | Périphérique de calcul |
| --wandb.enable | Activer la visualisation wandb |
| --wandb.project | Nom du projet wandb |
| --policy.push_to_hub | Envoyer le modèle entraîné vers le cloud HuggingFace |
| --steps | Nombre de steps d'entraînement |
| --batch_size | Quantité de données entrée par step ; si la VRAM est insuffisante, il faut la réduire |
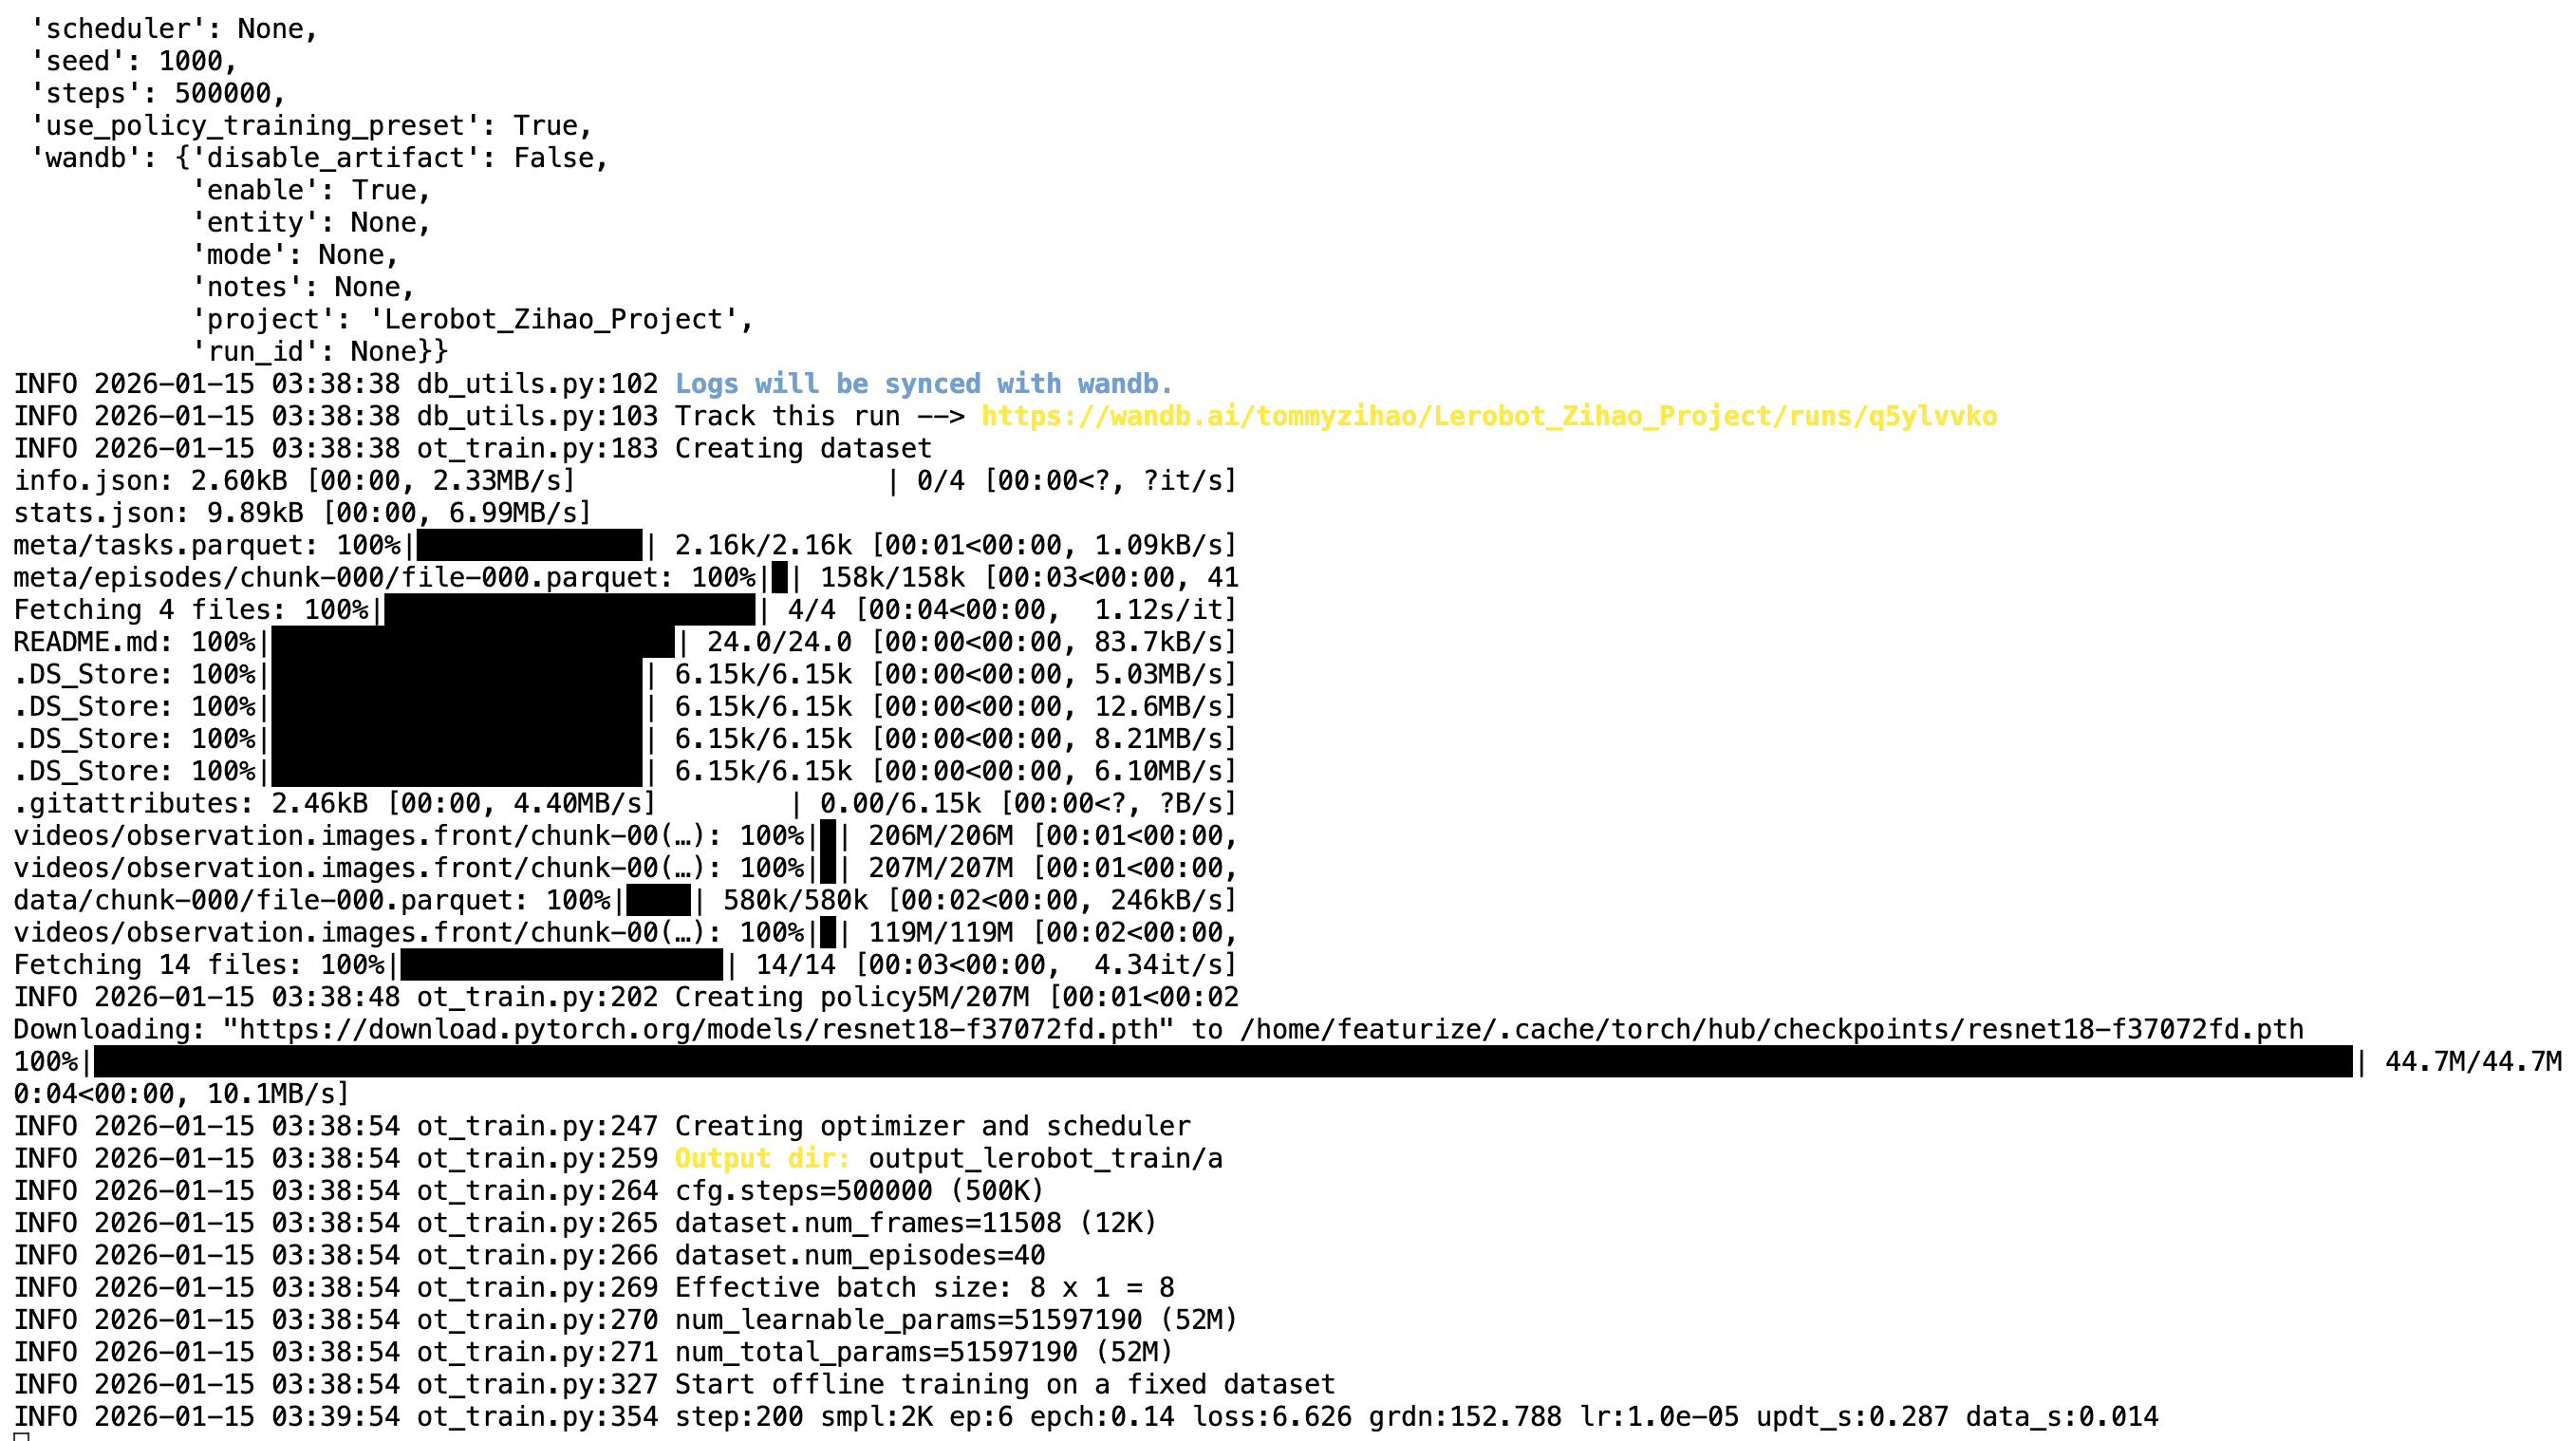
Processus d'entraînement
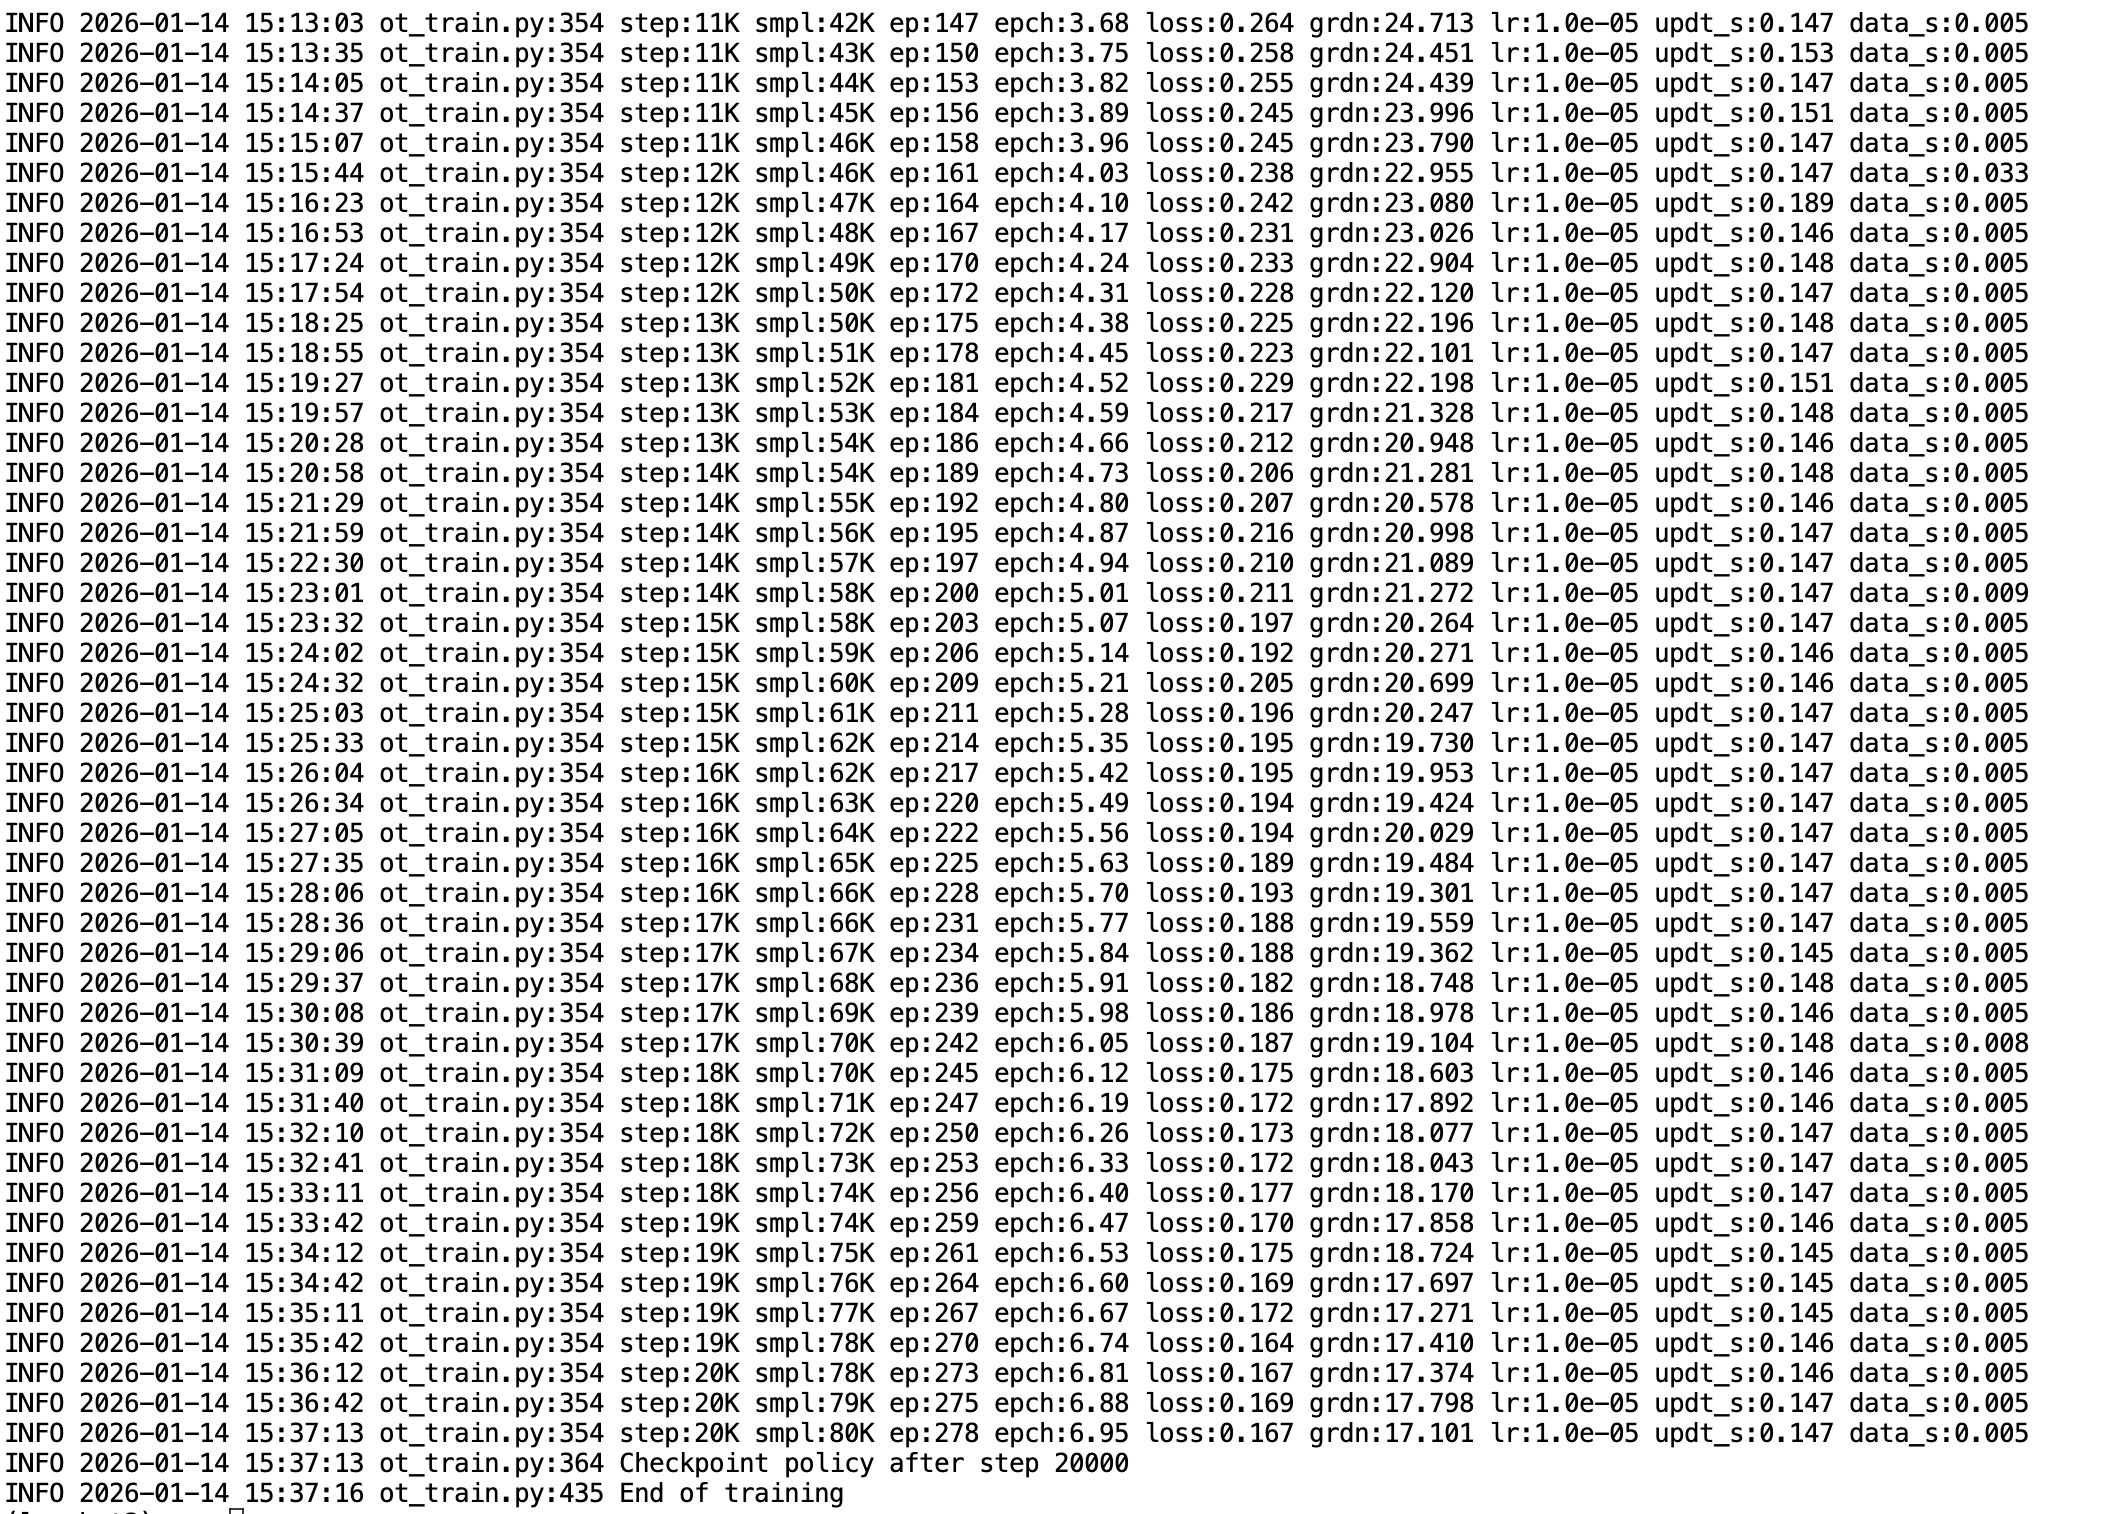
L'archive du modèle fait environ 300 Mo