

Comando de treino-ACT (recomendado para começar)
Documentação de referência
https://github.com/huggingface/lerobot/blob/46e19ae579f80ce66211afafd1c3c649c569131f/docs/source/act.mdx
https://github.com/huggingface/lerobot/blob/main/src/lerobot/scripts/lerobot_train.py
https://github.com/huggingface/lerobot/blob/main/src/lerobot/configs/train.py
Porquê começar pelo algoritmo ACT
O ACT é o primeiro modelo mais recomendado para treinar no LeRobot; as suas vantagens são as seguintes:
O modelo é muito leve, com apenas oitenta milhões de parâmetros treináveis
A convergência do treino é muito rápida, e a inferência também é rápida
Numa única GPU, uma hora de treino já mostra resultados
O pacote comprimido do modelo ACT tem cerca de 200MB, muito fácil de armazenar e transportar
Recolher 30 episódios de dados no dataset é basicamente suficiente
Pode ser implantado para inferência num computador Ubuntu, num computador Mac, num computador Windows e até num Raspberry Pi
O resultado da inferência no robô real é bastante bom, suficiente para tarefas simples como apanhar, apertar a mão e colocar canetas
O algoritmo ACT já vem incluído no ambiente básico da biblioteca LeRobot, sem necessidade de instalar outras bibliotecas
Linha de comando
lerobot-train \
  --dataset.repo_id=Tommymy/lerobot_my_dataset_shake_hands \
  --dataset.root=~/lerobot_my_dataset_shake_hands \
  --dataset.revision=v0.1.0 \
  --dataset.streaming=false \
  --policy.type=act \
  --output_dir=~/output_lerobot_train/shake/act/ \
  --job_name=shake_act_a \
  --policy.device=cuda \
  --wandb.enable=true \
  --wandb.project=Lerobot_my_Project \
  --policy.push_to_hub=false \
  --steps=20000 \
  --batch_size=8
Descrição da linha de comando
Antes do caractere de quebra de linha \ só pode haver um espaço, e depois não pode haver espaço
A vermelho estão os parâmetros que devem ser verificados ou alterados antes de cada execução
| Parâmetro da linha de comando | Descrição |
|---|---|
| --dataset.repo_id | O Repo_ID do dataset no HuggingFace |
| --dataset.root | Caminho local do dataset |
| --dataset.revision | Versão do dataset, especificada quando o dataset foi carregado para o HuggingFace |
| --dataset.streaming | O dataset está local, tem de ser false, porque o dataset já está no local e não é necessária leitura em streaming |
| --dataset.split | Por predefinição é train, ou seja, usa todos os dados como conjunto de treino |
| --policy.type | O algoritmo a treinar, como act, smolvla, diffusion, pi0, wallx |
| --output_dir | Diretório onde a saída do treino é guardada |
| --job_name | O nome desta tarefa de treino |
| --policy.device | Dispositivo de computação |
| --wandb.enable | Ativa a visualização do wandb |
| --wandb.project | Nome do projeto no wandb |
| --policy.push_to_hub | Envia o modelo treinado para a nuvem do HuggingFace |
| --steps | Número de passos de treino |
| --batch_size | Quantidade de dados de entrada por passo; se a VRAM não for suficiente, deve ser reduzida |
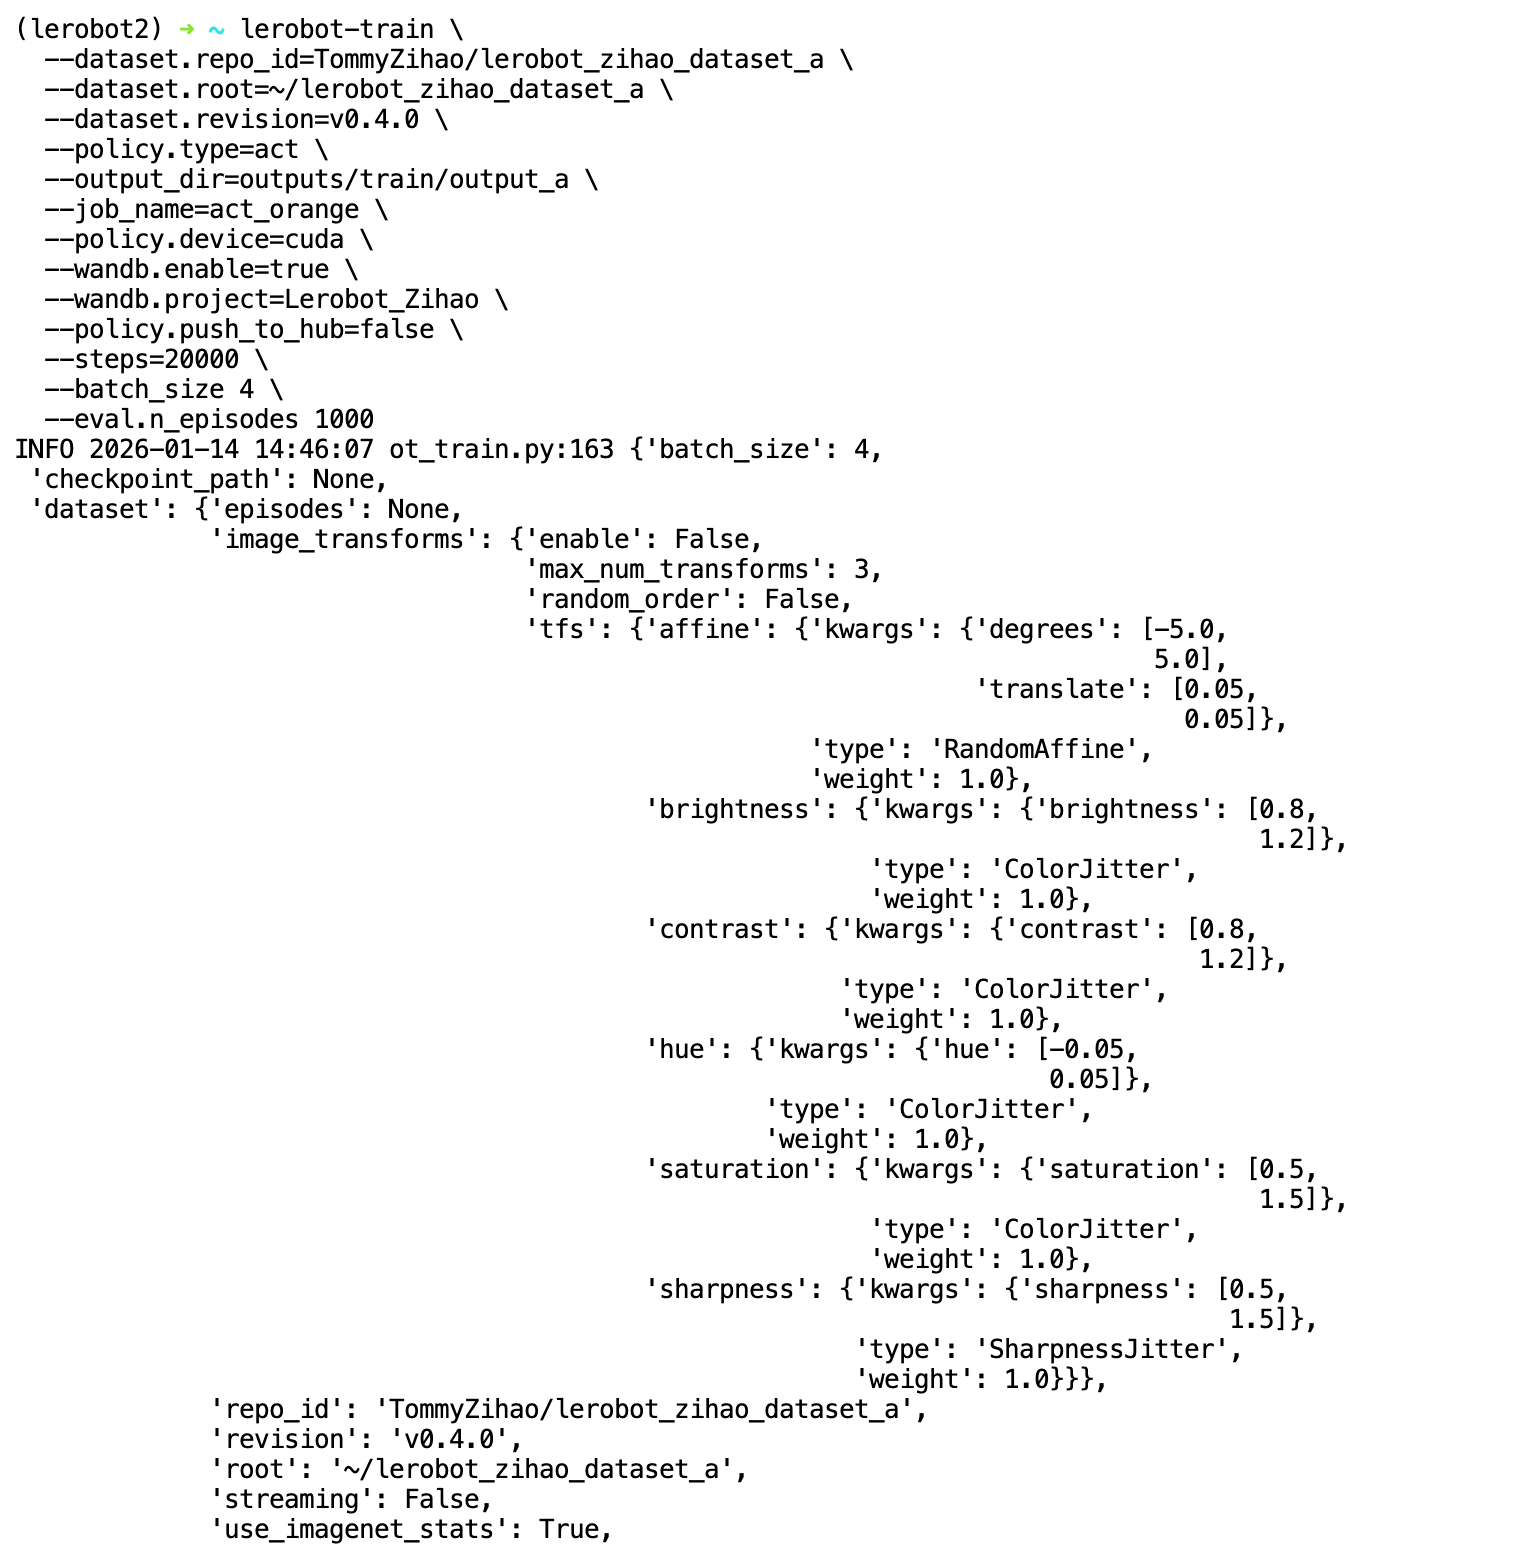
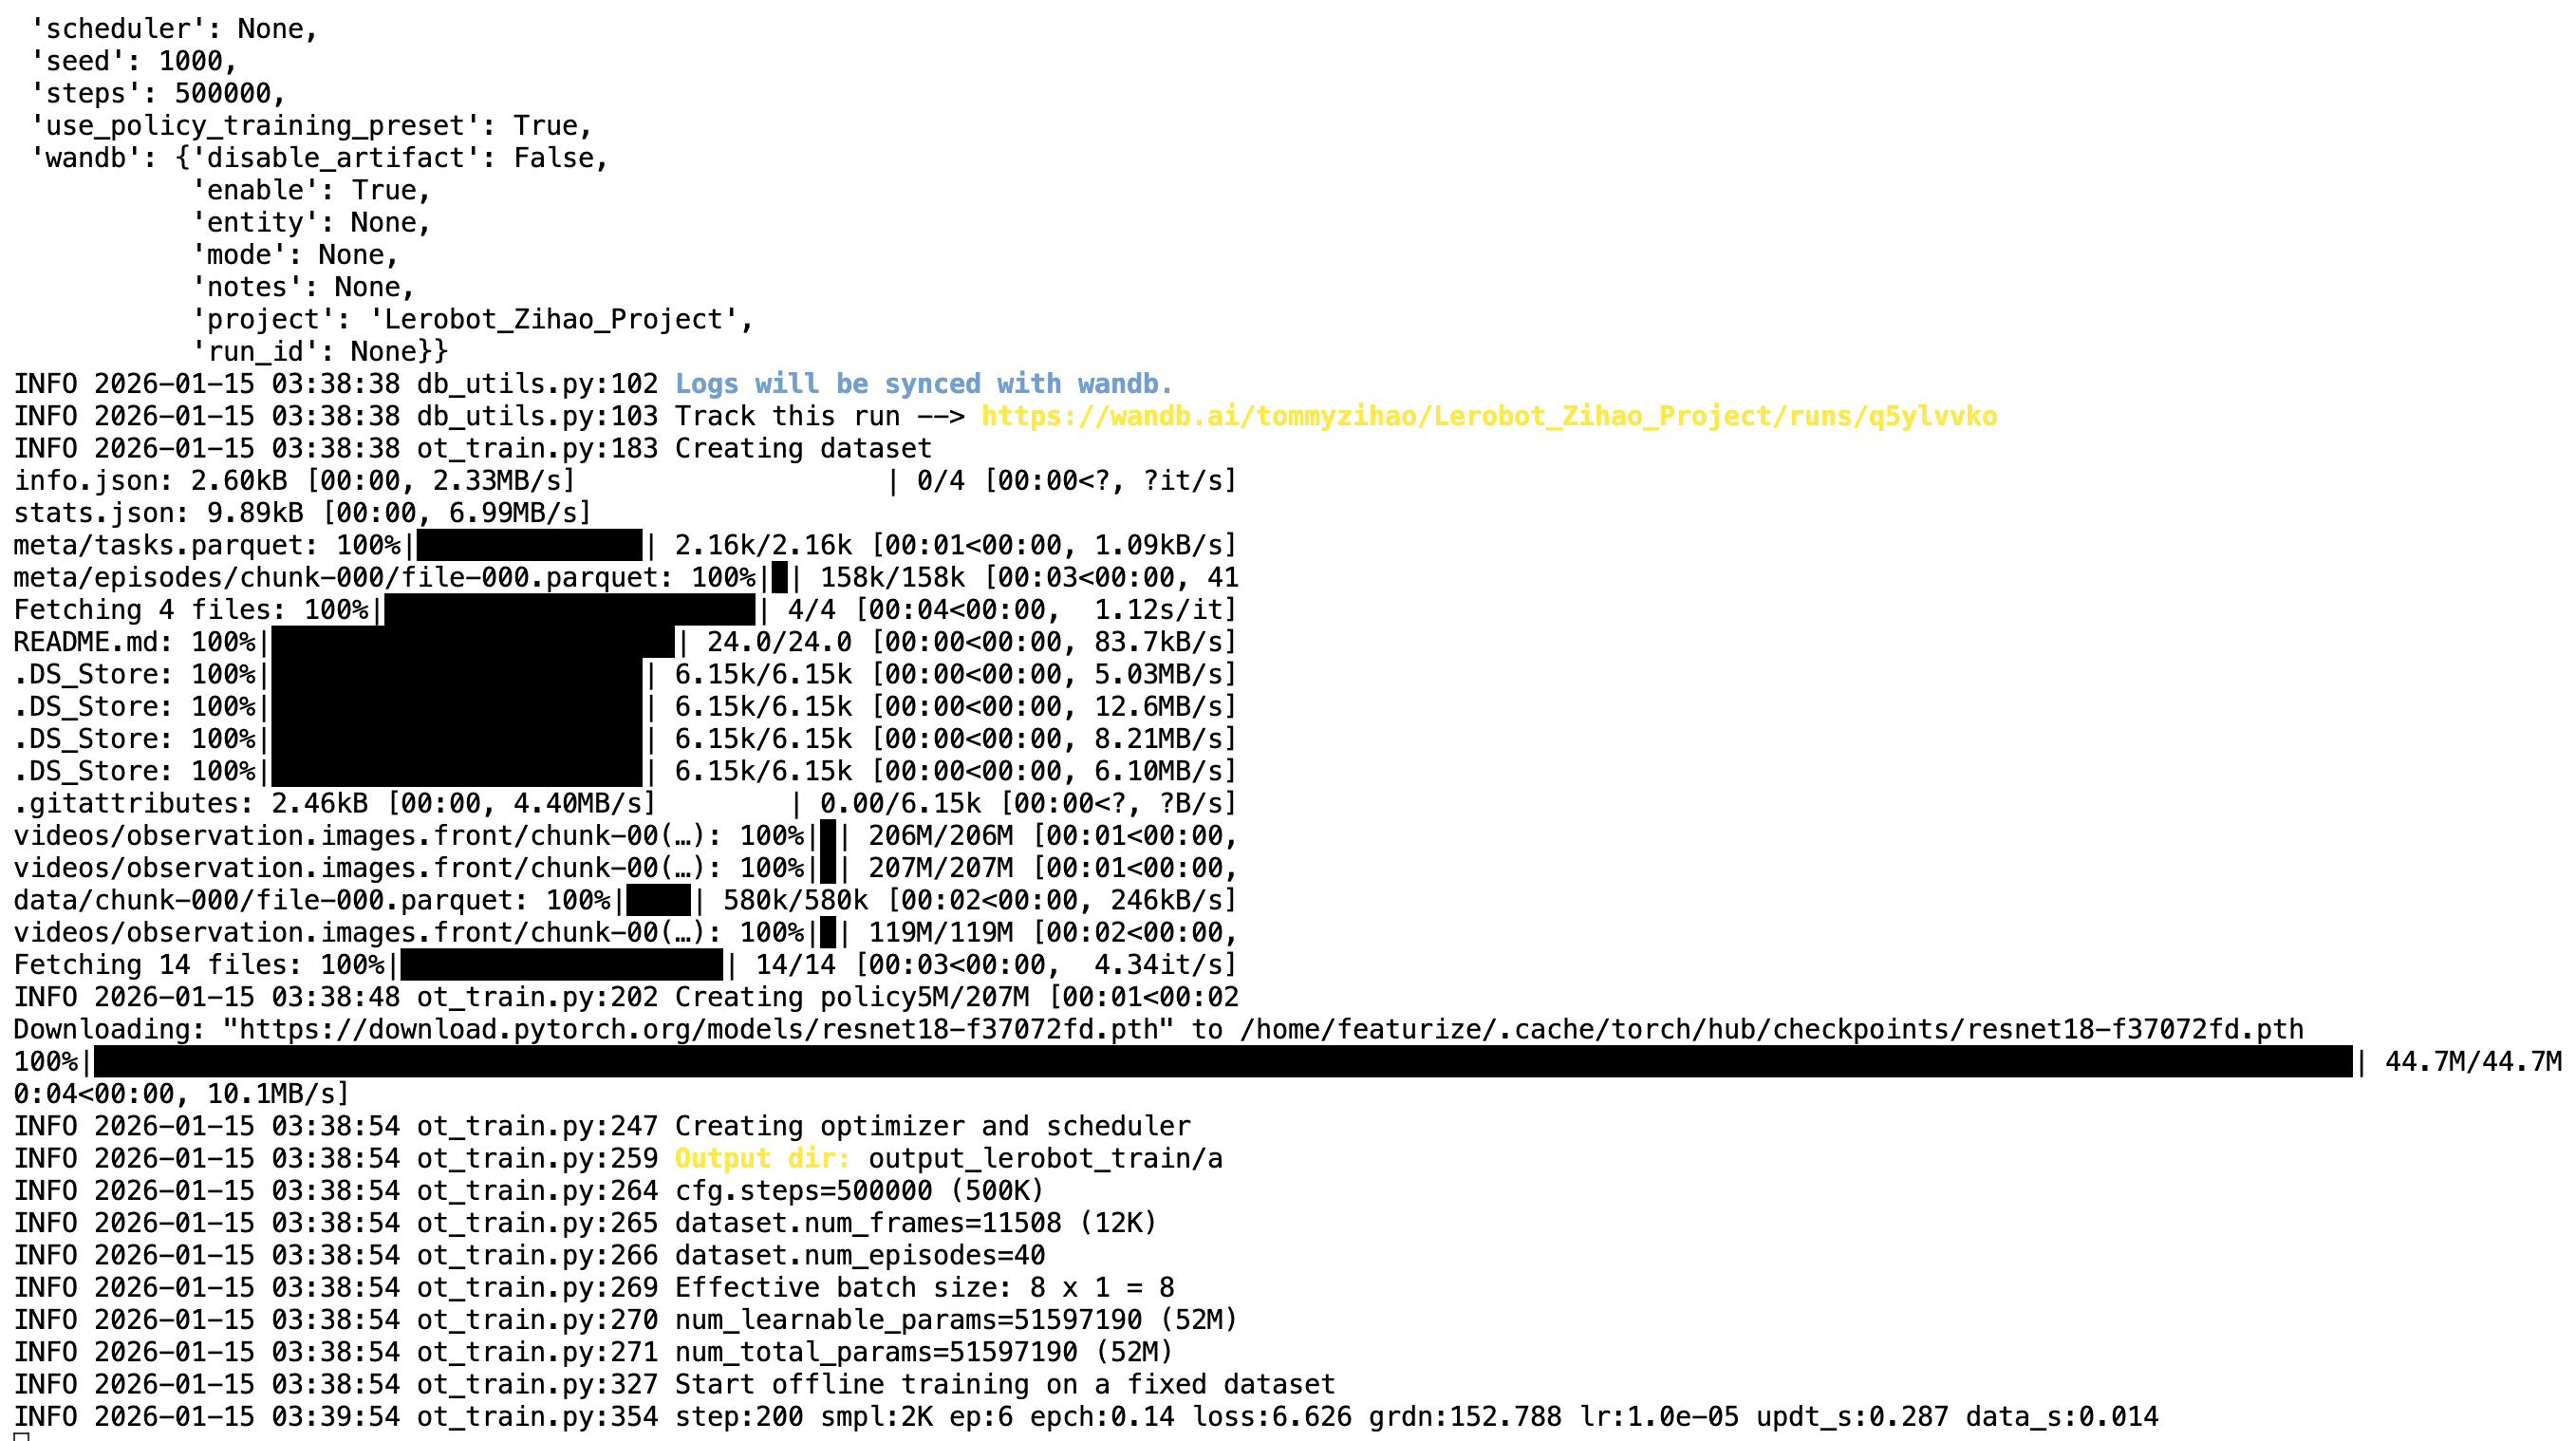
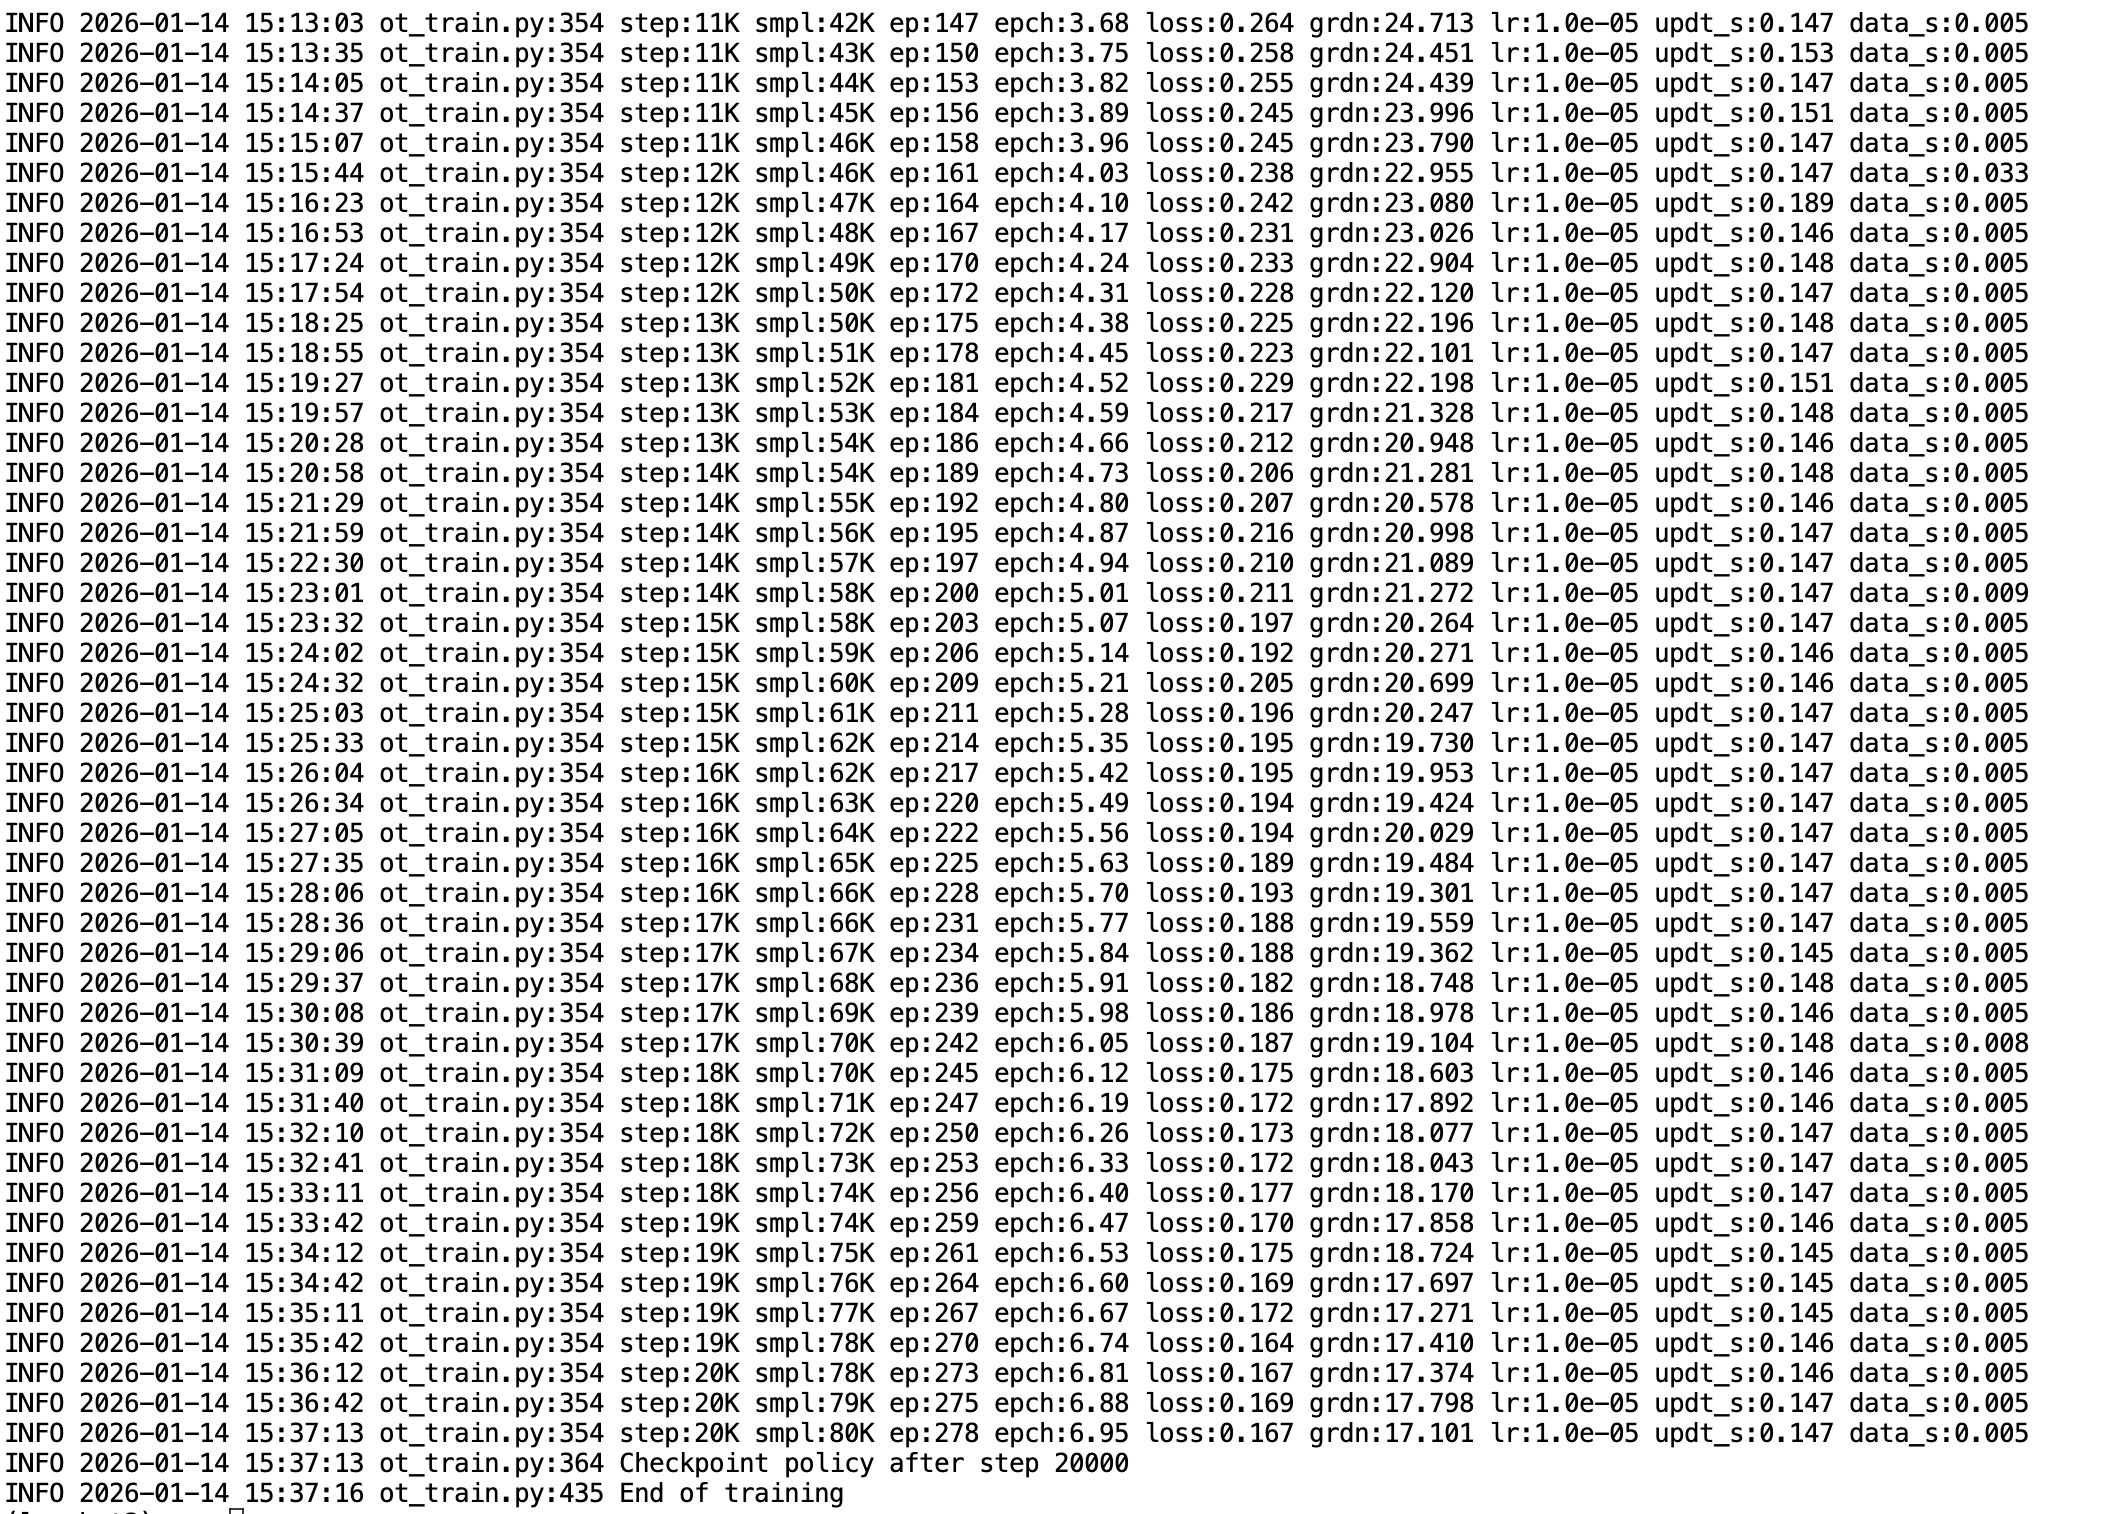
Processo de treino
O pacote comprimido do modelo tem cerca de 300MB