

Comando di addestramento-ACT (consigliato per iniziare)
Documentazione di riferimento
https://github.com/huggingface/lerobot/blob/46e19ae579f80ce66211afafd1c3c649c569131f/docs/source/act.mdx
https://github.com/huggingface/lerobot/blob/main/src/lerobot/scripts/lerobot_train.py
https://github.com/huggingface/lerobot/blob/main/src/lerobot/configs/train.py
Perché iniziare dall'algoritmo ACT
ACT è il primo modello che si consiglia di addestrare quando si usa LeRobot; i suoi vantaggi sono i seguenti:
Il modello è estremamente leggero: ha solo ottanta milioni di parametri addestrabili
La convergenza dell'addestramento è molto rapida e anche l'inferenza è veloce
Con una singola GPU si vedono risultati dopo un'ora di addestramento
L'archivio compresso del modello ACT è di circa 200 MB, molto comodo da archiviare e trasferire
Per il dataset, raccogliere circa 30 episodi di dati è generalmente sufficiente
Può essere distribuito per l'inferenza su un computer host Ubuntu, un computer Mac, un computer Windows e persino su un Raspberry Pi
L'effetto dell'inferenza sul robot reale è comunque piuttosto buono, sufficiente per task semplici come afferrare, stringere la mano o posare una penna
L'algoritmo ACT è già incluso nell'ambiente di base della libreria LeRobot, non è necessario installare altre librerie
Comandi
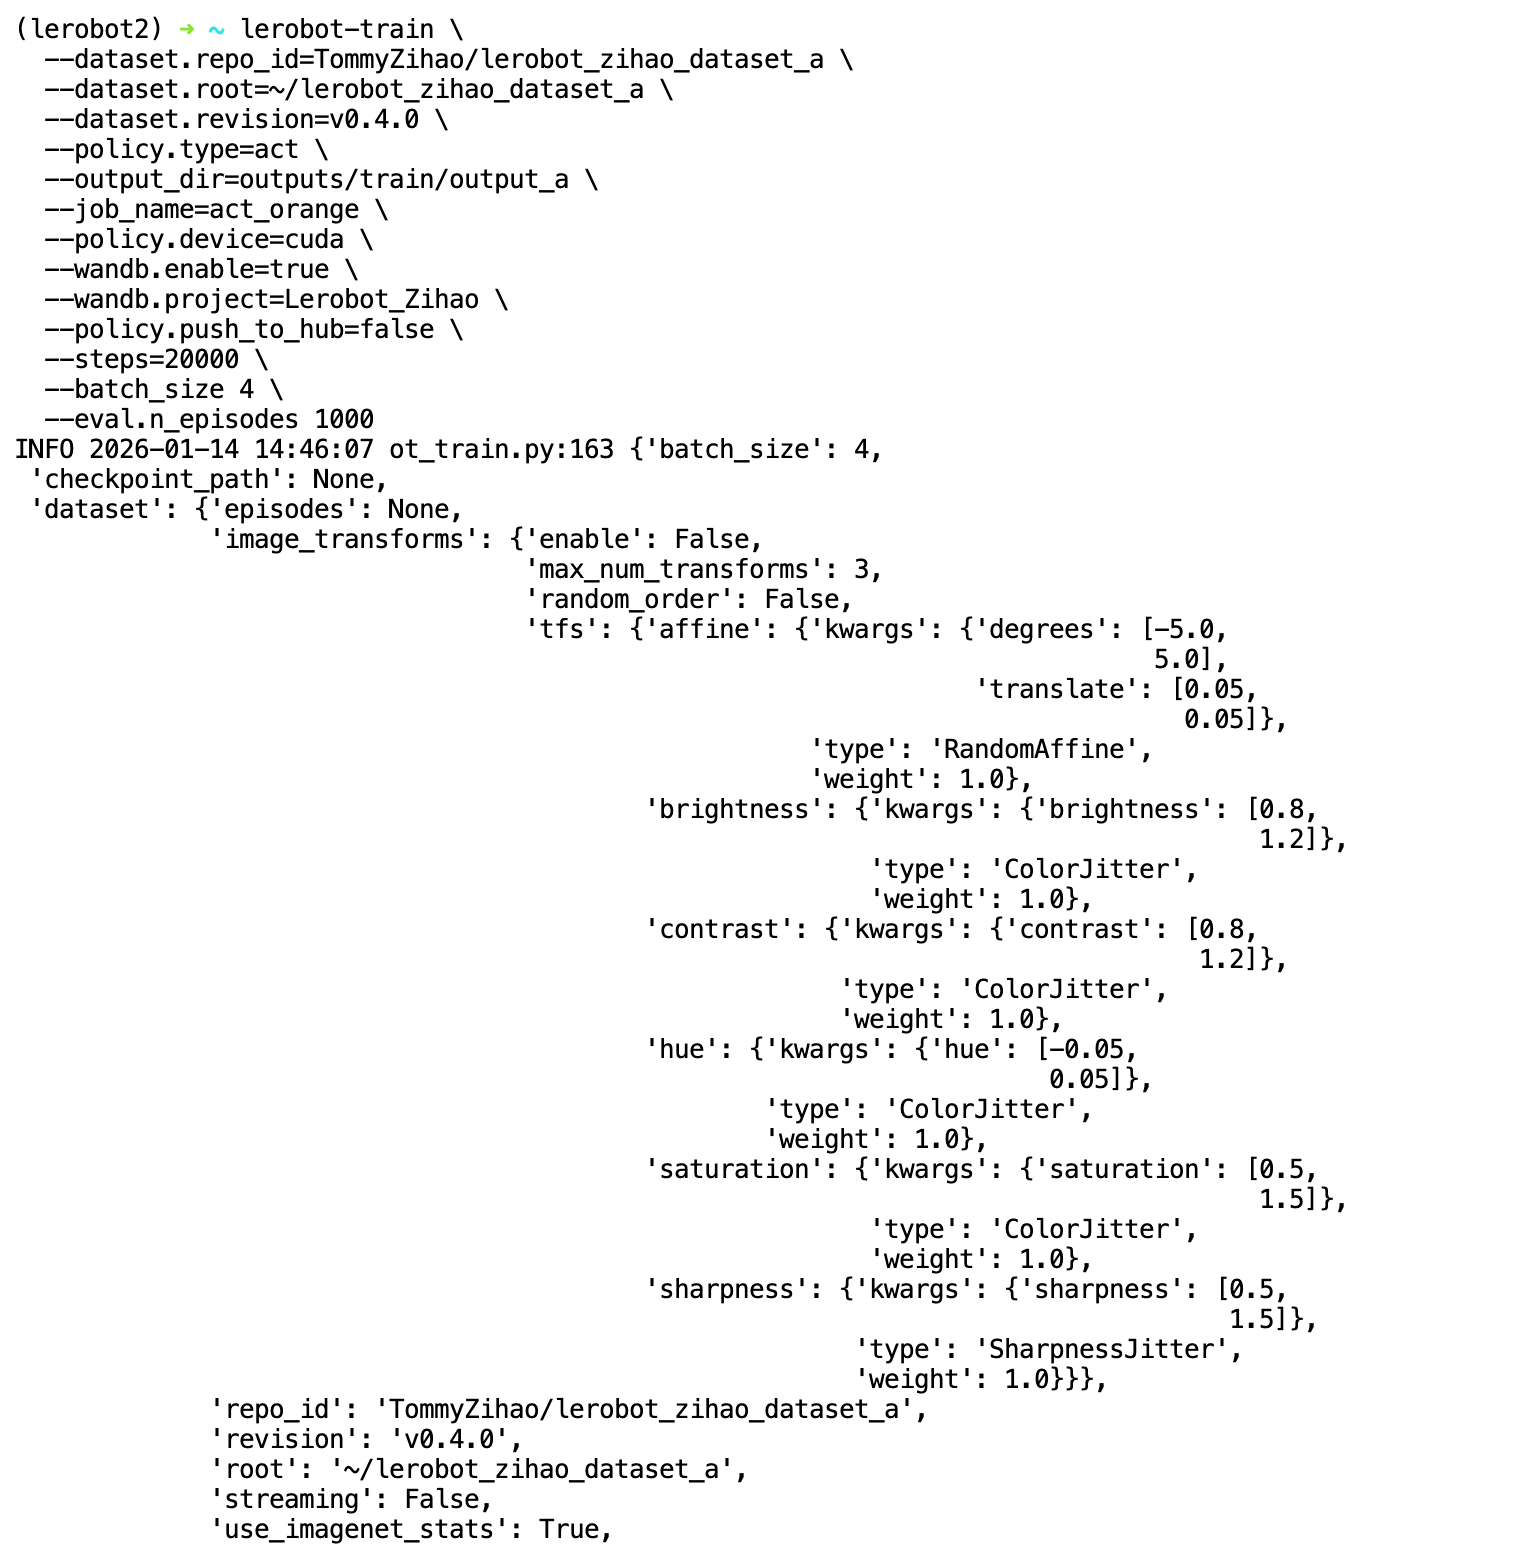
lerobot-train \
  --dataset.repo_id=Tommymy/lerobot_my_dataset_shake_hands \
  --dataset.root=~/lerobot_my_dataset_shake_hands \
  --dataset.revision=v0.1.0 \
  --dataset.streaming=false \
  --policy.type=act \
  --output_dir=~/output_lerobot_train/shake/act/ \
  --job_name=shake_act_a \
  --policy.device=cuda \
  --wandb.enable=true \
  --wandb.project=Lerobot_my_Project \
  --policy.push_to_hub=false \
  --steps=20000 \
  --batch_size=8
Descrizione dei comandi
Prima del carattere di continuazione di riga \ può esserci un solo spazio, dopo non deve esserci alcuno spazio
In rosso i parametri da controllare o modificare prima di ogni esecuzione
| Parametro della riga di comando | Descrizione |
|---|---|
| --dataset.repo_id | Repo_ID del dataset HuggingFace |
| --dataset.root | Percorso locale del dataset |
| --dataset.revision | Versione del dataset, specificata al momento del caricamento del dataset su HuggingFace |
| --dataset.streaming | Il dataset è in locale, deve essere false, poiché il dataset è già in locale e non è necessaria la lettura in streaming |
| --dataset.split | Il valore predefinito è train, cioè si usa l'intero dataset come set di addestramento |
| --policy.type | Algoritmo da addestrare, ad esempio act, smolvla, diffusion, pi0, wallx |
| --output_dir | Directory in cui salvare l'output |
| --job_name | Nome dell'attività di addestramento corrente |
| --policy.device | Dispositivo di calcolo |
| --wandb.enable | Abilita la visualizzazione wandb |
| --wandb.project | Nome del progetto wandb |
| --policy.push_to_hub | Invia il modello addestrato al cloud HuggingFace |
| --steps | Numero di step di addestramento |
| --batch_size | Quantità di dati inserita in uno step; se la VRAM non è sufficiente, va ridotta |
Processo di addestramento
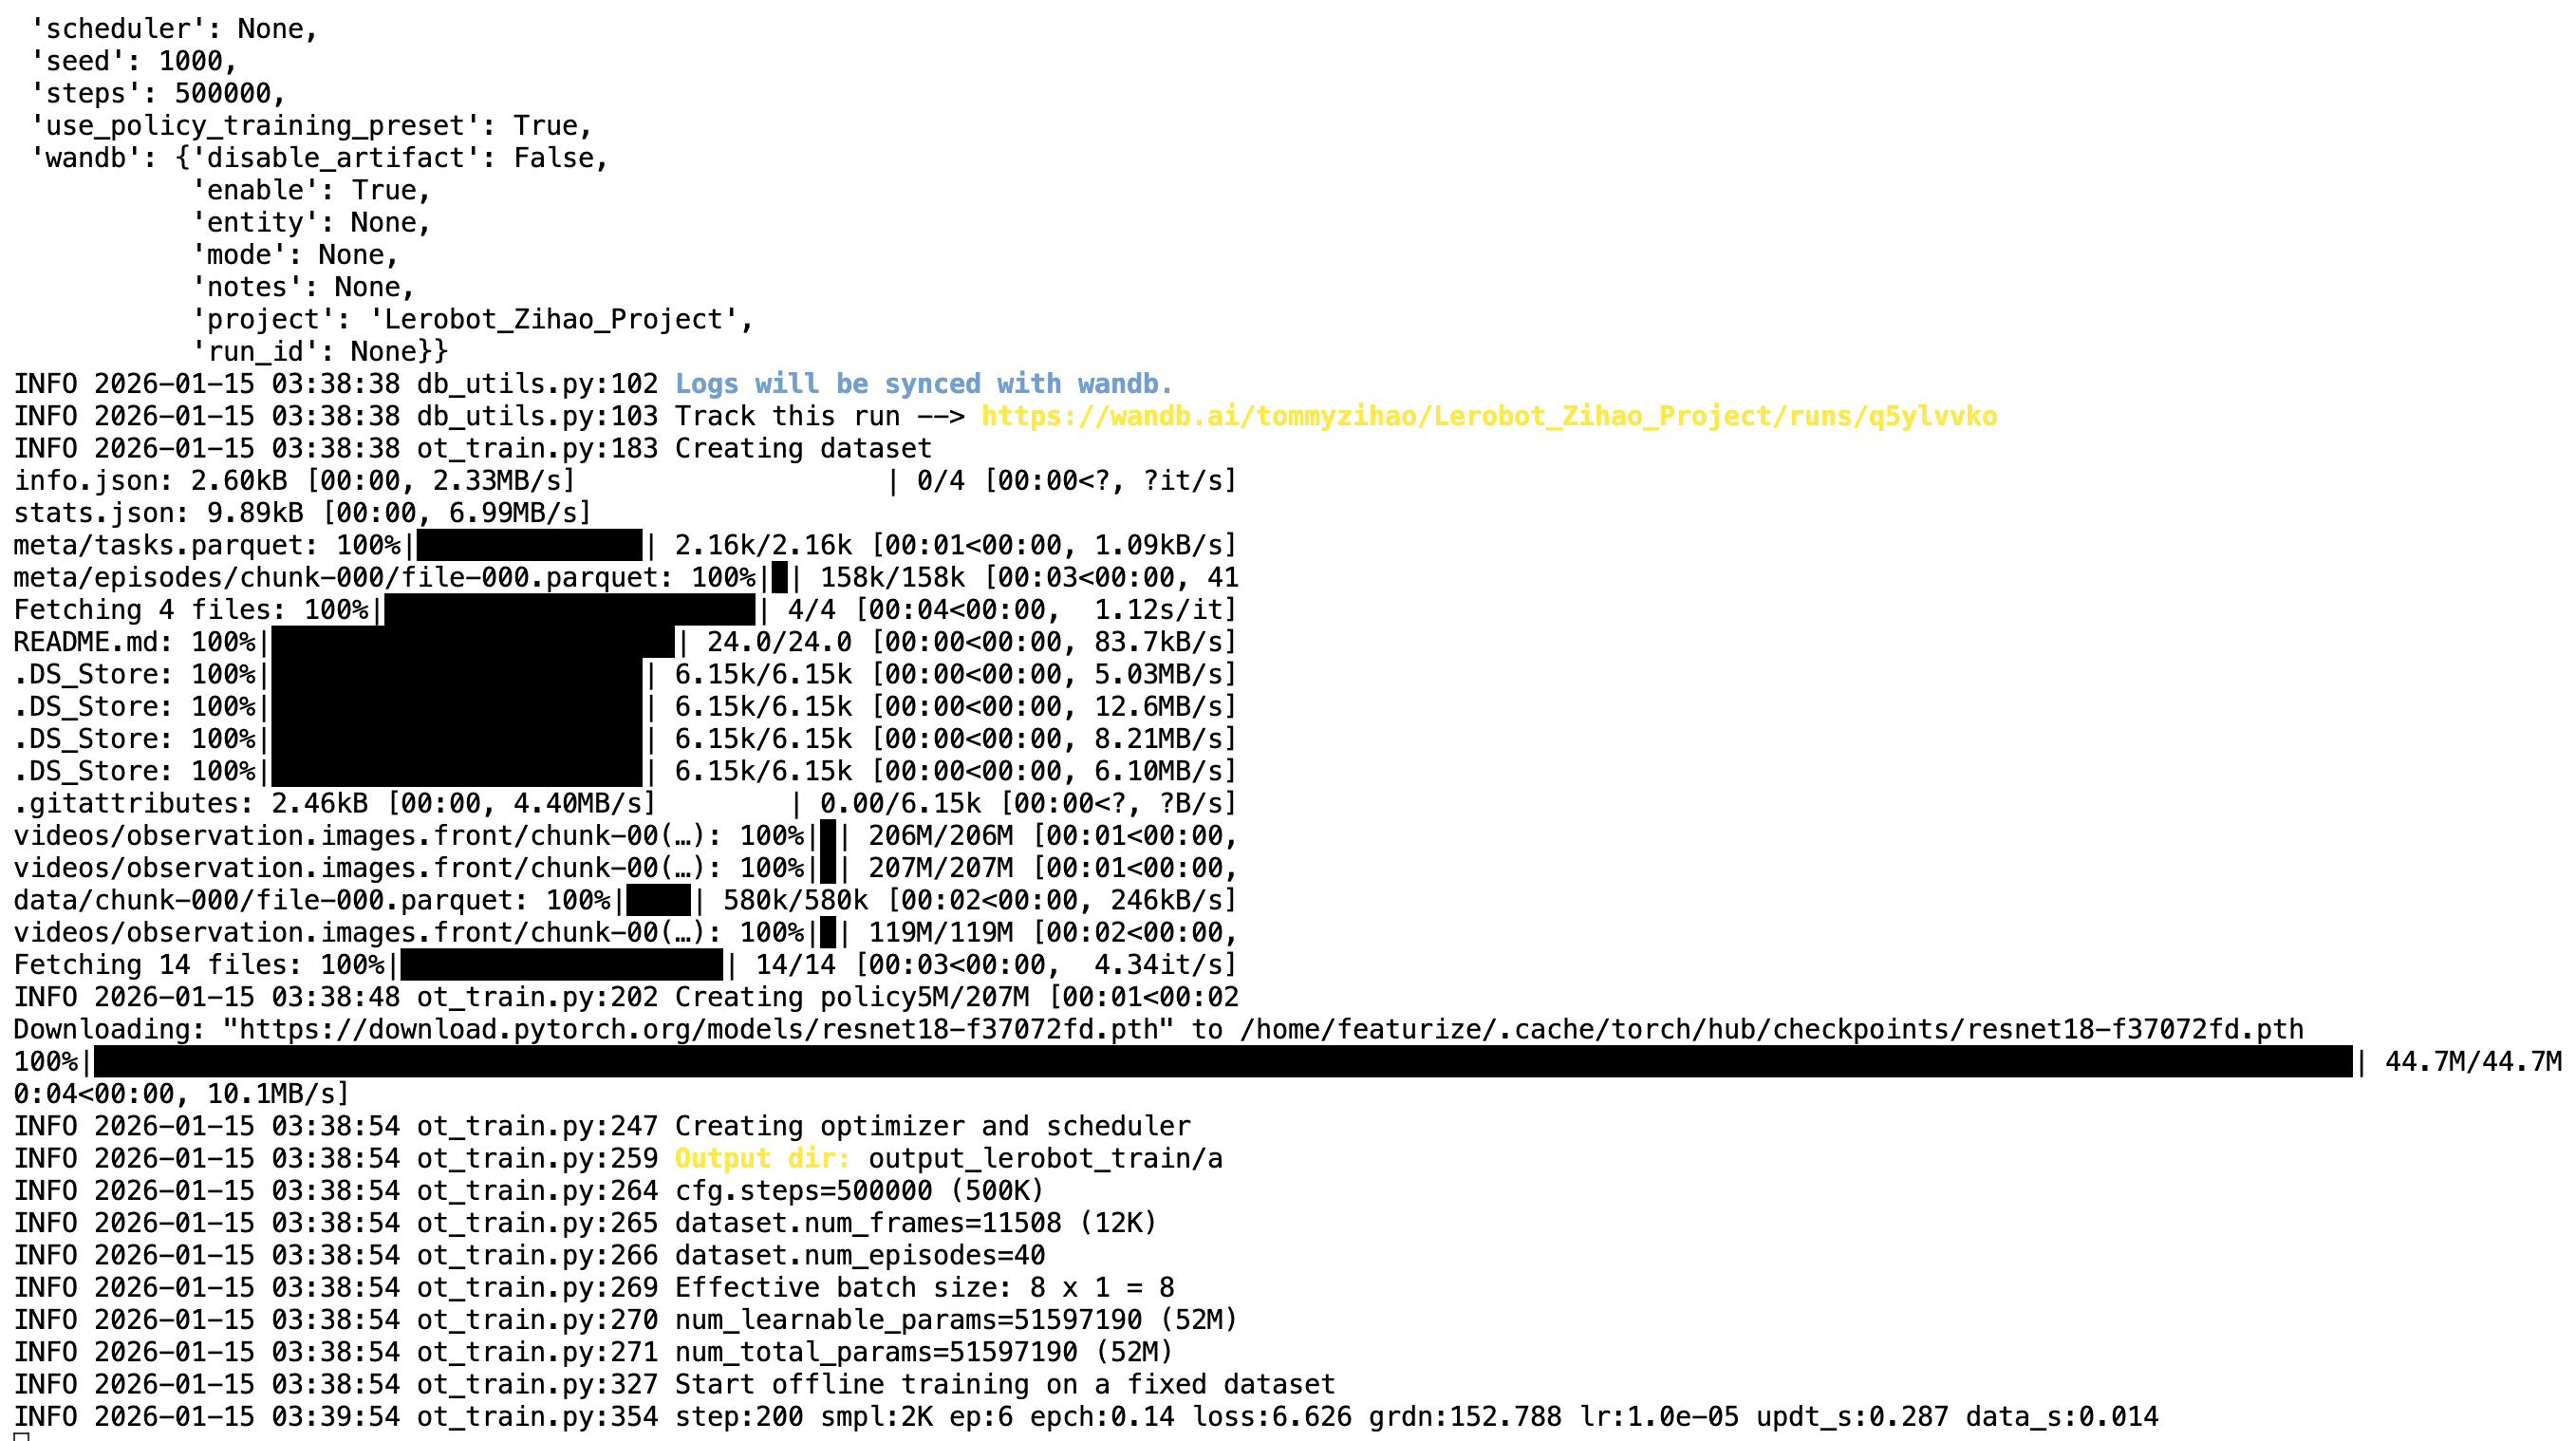
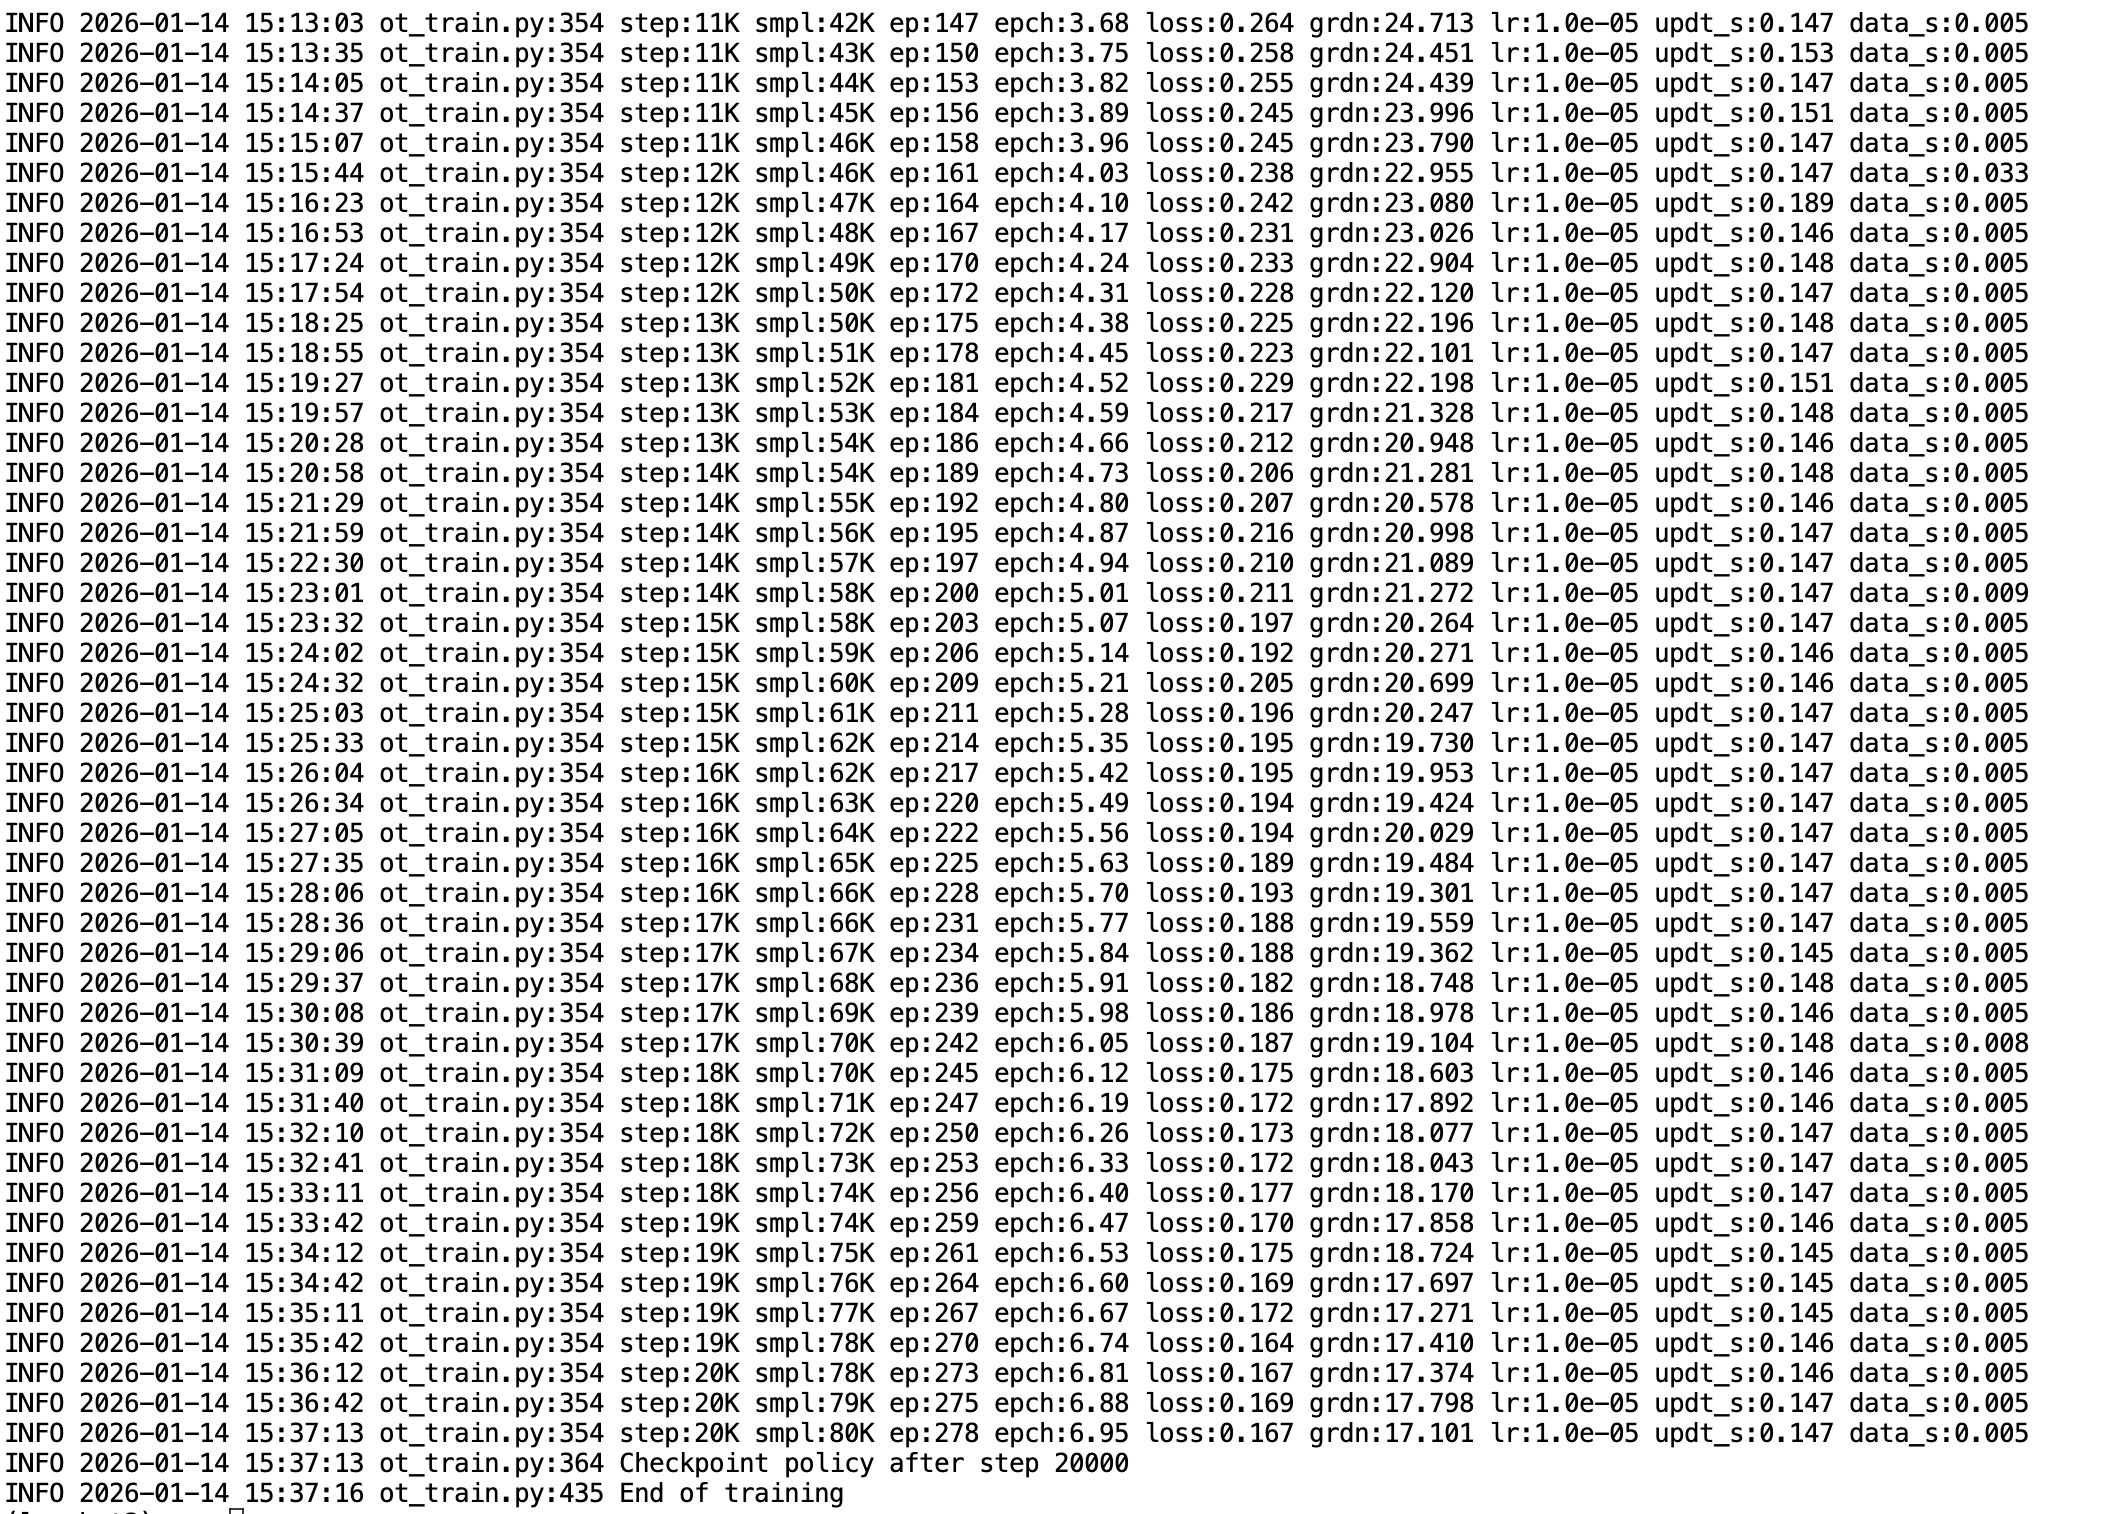
L'archivio del modello è di circa 300 MB