

Trainingsbefehl-ACT (empfohlen für den Einstieg)
Referenzdokumentation
https://github.com/huggingface/lerobot/blob/46e19ae579f80ce66211afafd1c3c649c569131f/docs/source/act.mdx
https://github.com/huggingface/lerobot/blob/main/src/lerobot/scripts/lerobot_train.py
https://github.com/huggingface/lerobot/blob/main/src/lerobot/configs/train.py
Warum mit dem ACT-Algorithmus beginnen
ACT ist das am meisten empfohlene erste Modell zum Trainieren mit LeRobot; seine Vorteile sind folgende:
Das Modell ist sehr leichtgewichtig und hat nur achtzig Millionen lernbare Parameter
Die Trainingskonvergenz ist sehr schnell, auch die Inferenzgeschwindigkeit ist sehr schnell
Auf einer einzelnen GPU sind Ergebnisse nach einer Stunde Training sichtbar
Das Download-Archiv des ACT-Modells umfasst etwa 200MB, sehr praktisch für Speicherung und Übertragung
Eine Datenerfassung von 30 Runden reicht in der Regel aus
Kann auf Ubuntu-Hosts, Mac-Computern, Windows-Computern und sogar Raspberry Pi inferiert werden
Die Inferenzergebnisse am echten Roboter sind recht gut und für einfache Aufgaben wie Greifen, Händeschütteln und Stiftablegen ausreichend
Der ACT-Algorithmus ist bereits in der Basisumgebung der LeRobot-Bibliothek enthalten, es müssen keine weiteren Bibliotheken installiert werden
Befehl
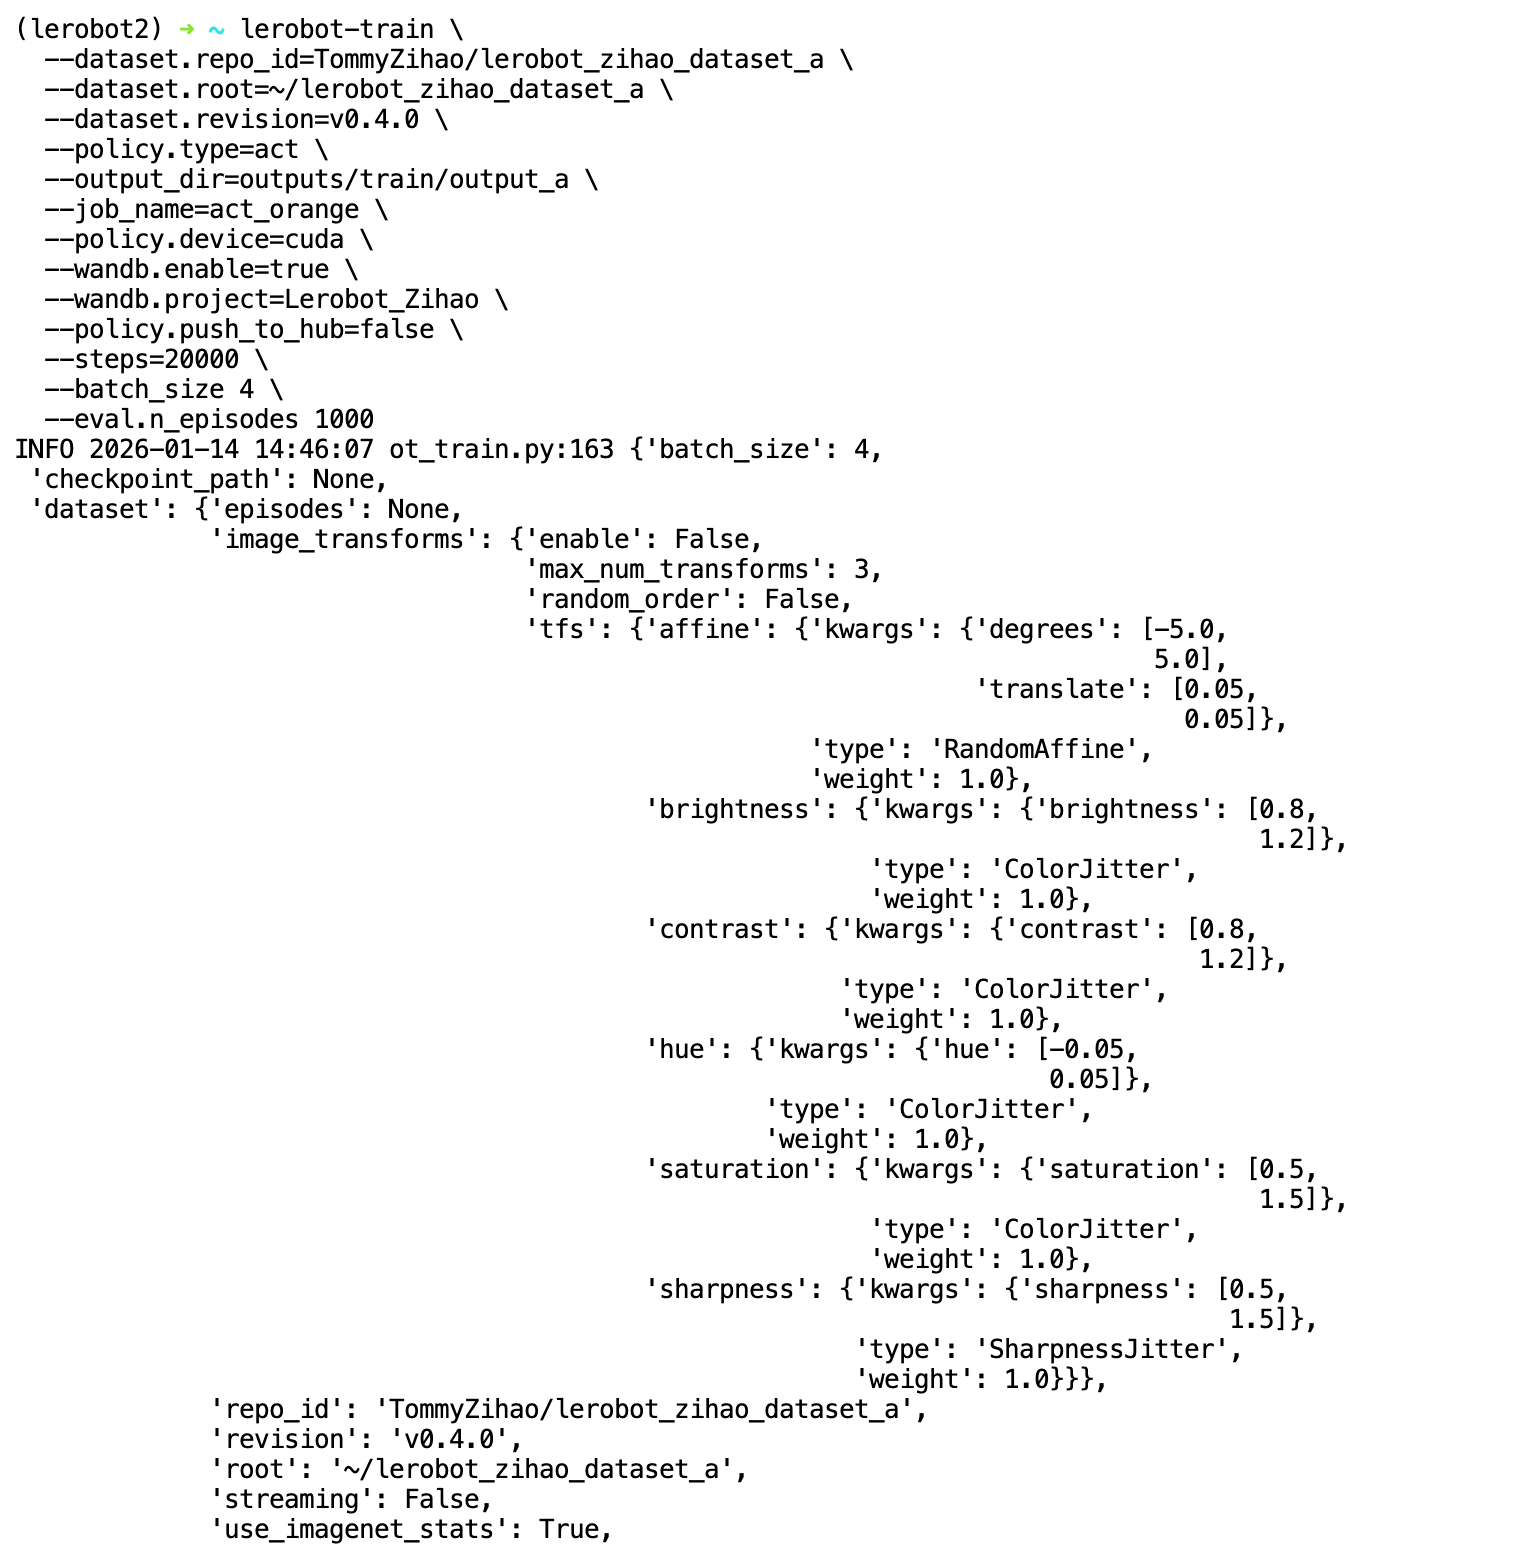
lerobot-train \
  --dataset.repo_id=Tommymy/lerobot_my_dataset_shake_hands \
  --dataset.root=~/lerobot_my_dataset_shake_hands \
  --dataset.revision=v0.1.0 \
  --dataset.streaming=false \
  --policy.type=act \
  --output_dir=~/output_lerobot_train/shake/act/ \
  --job_name=shake_act_a \
  --policy.device=cuda \
  --wandb.enable=true \
  --wandb.project=Lerobot_my_Project \
  --policy.push_to_hub=false \
  --steps=20000 \
  --batch_size=8
Erläuterung des Befehls
Vor dem Zeilenumbruchzeichen \ darf nur ein Leerzeichen stehen, danach darf kein Leerzeichen folgen
Rot markiert sind Parameter, die vor jedem Lauf geprüft oder geändert werden müssen
| Befehlsparameter | Beschreibung |
|---|---|
| --dataset.repo_id | Repo_ID des HuggingFace-Datensatzes |
| --dataset.root | Lokaler Pfad des Datensatzes |
| --dataset.revision | Datensatzversion, wurde beim Hochladen des Datensatzes zu HuggingFace angegeben |
| --dataset.streaming | Der Datensatz liegt lokal, muss false sein, denn der Datensatz ist bereits lokal, kein Stream-Reading erforderlich |
| --dataset.split | Standard ist train, d. h. alle Daten werden als Trainingssatz verwendet |
| --policy.type | Der zu trainierende Algorithmus, z. B. act, smolvla, diffusion, pi0, wallx |
| --output_dir | Verzeichnis, in dem die Trainingsausgabe gespeichert wird |
| --job_name | Name dieses Trainingsauftrags |
| --policy.device | Rechengerät |
| --wandb.enable | wandb-Visualisierung aktivieren |
| --wandb.project | wandb-Projektname |
| --policy.push_to_hub | Das trainierte Modell in die HuggingFace-Cloud hochladen |
| --steps | Trainingsschritte |
| --batch_size | Datenmenge pro Schritt; bei unzureichendem VRAM sollte sie verkleinert werden |
Trainingsverlauf
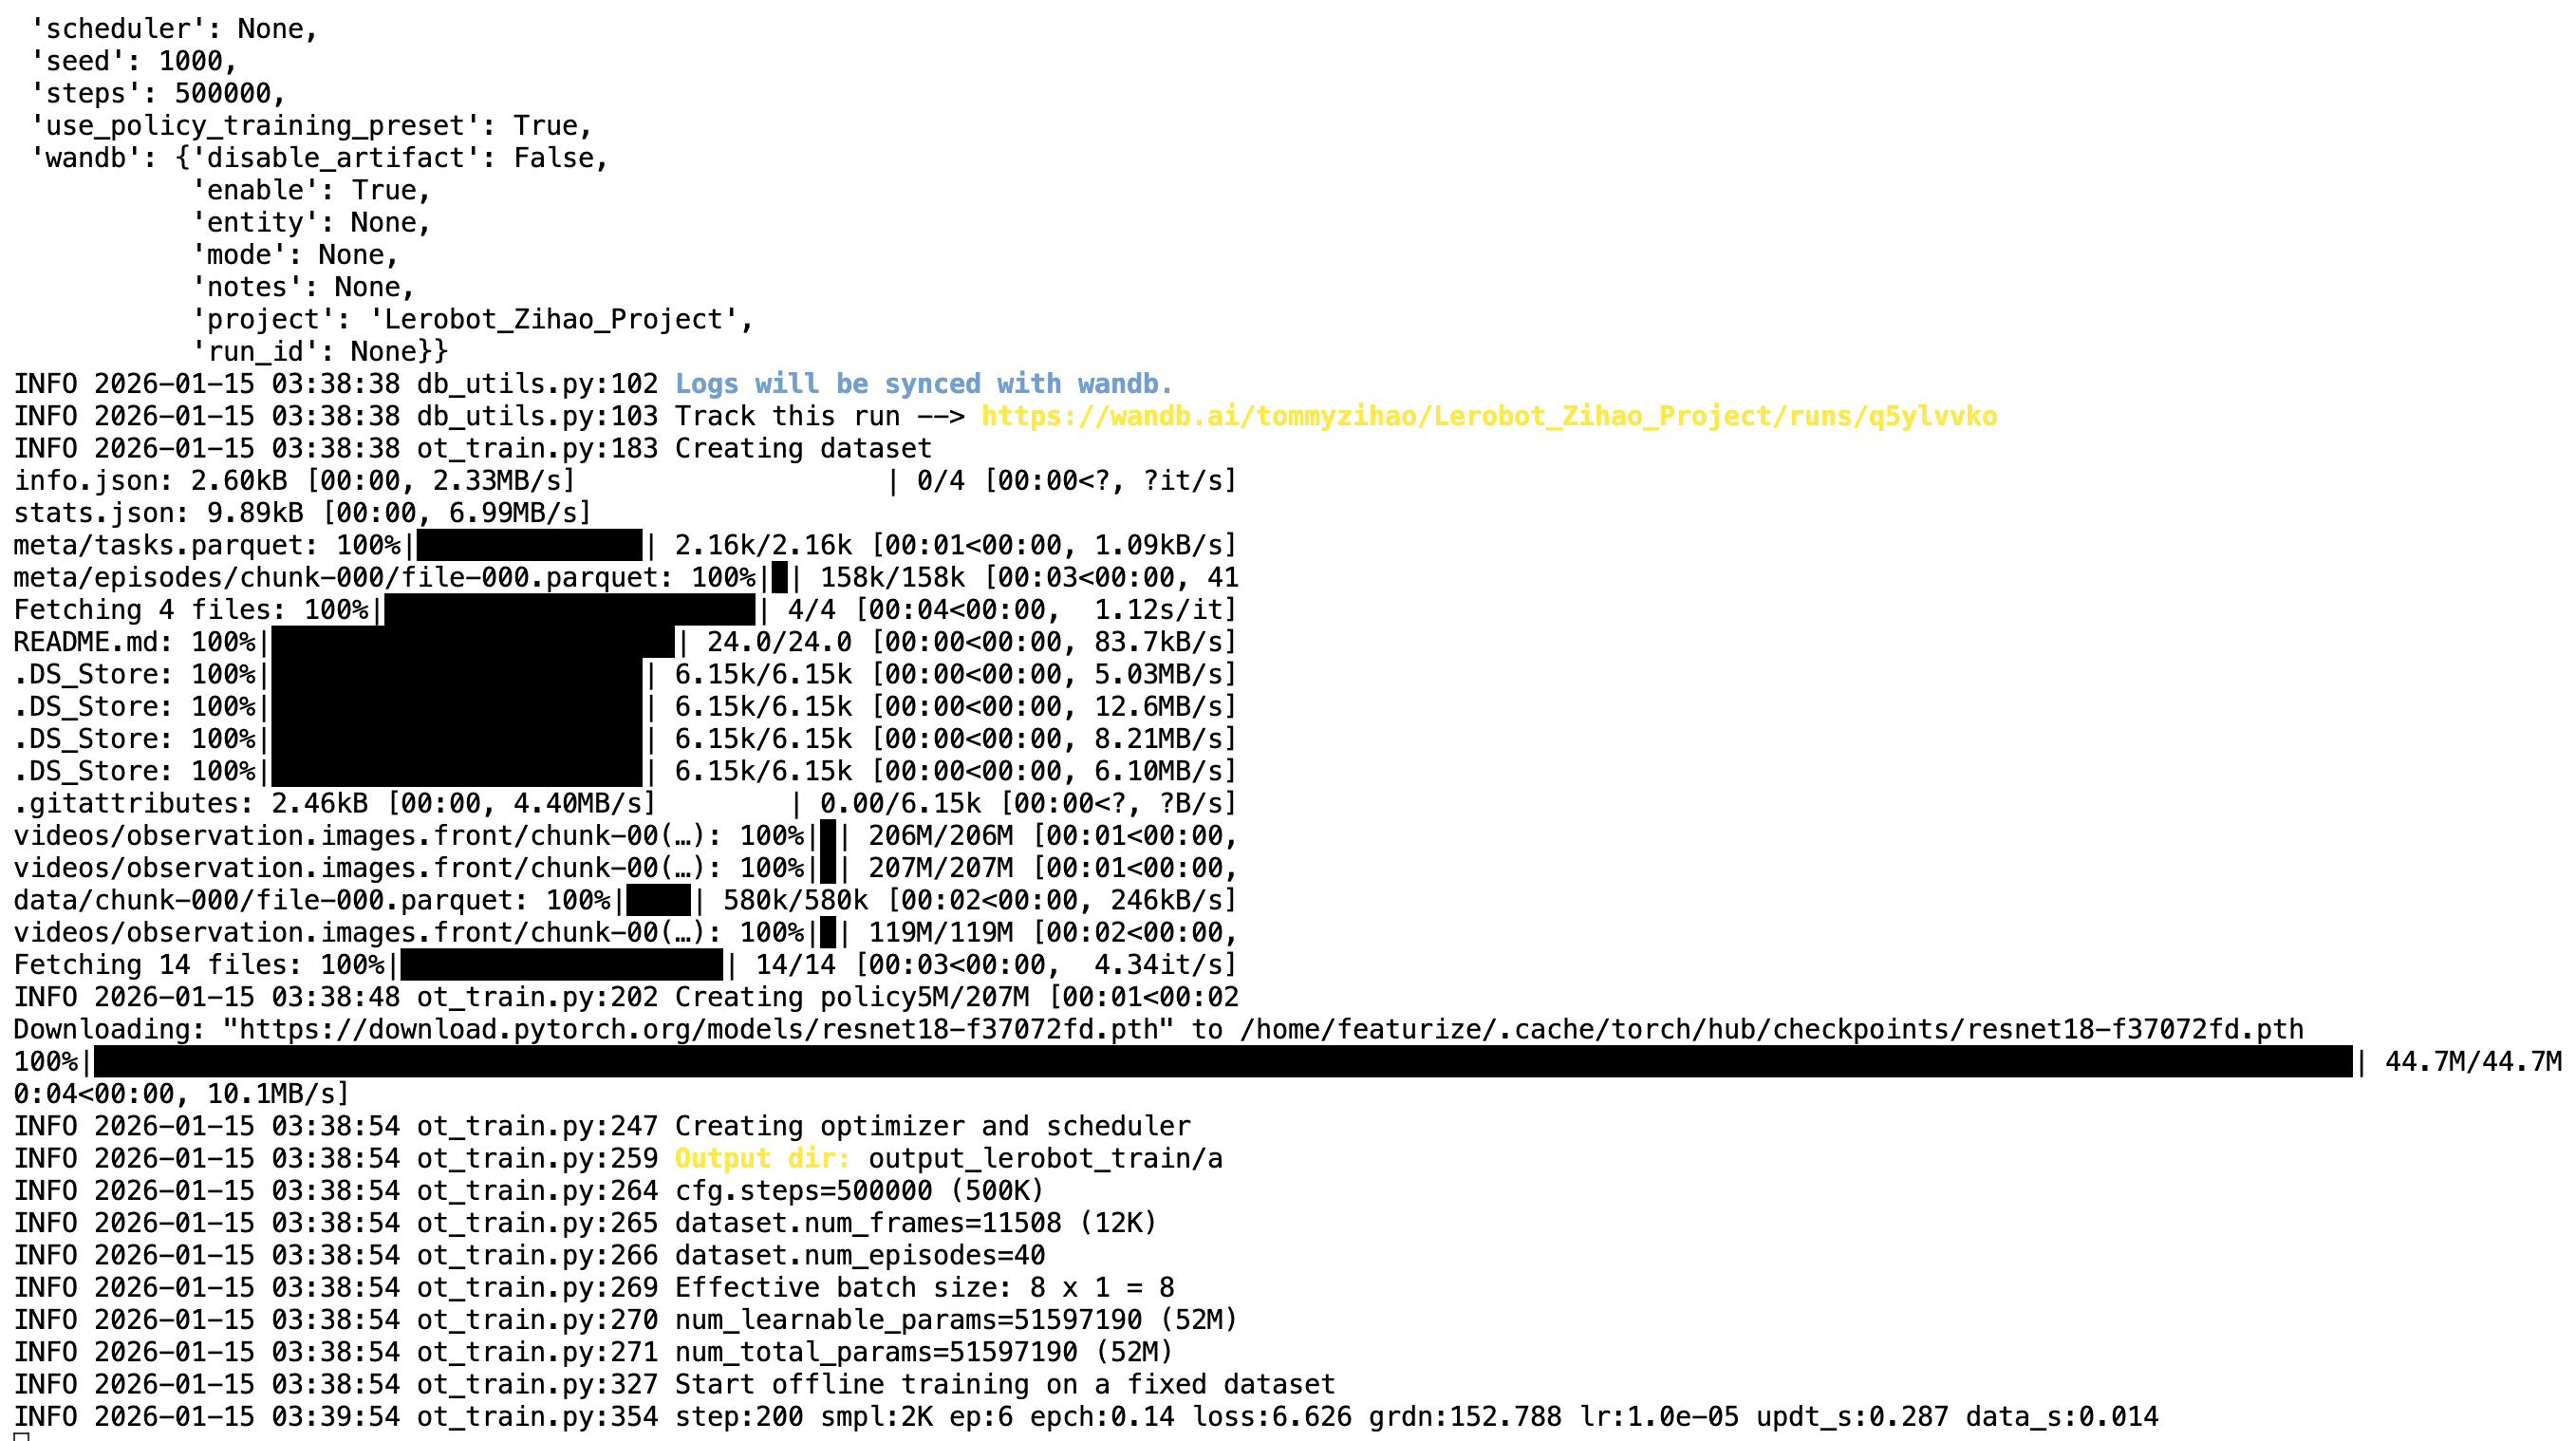
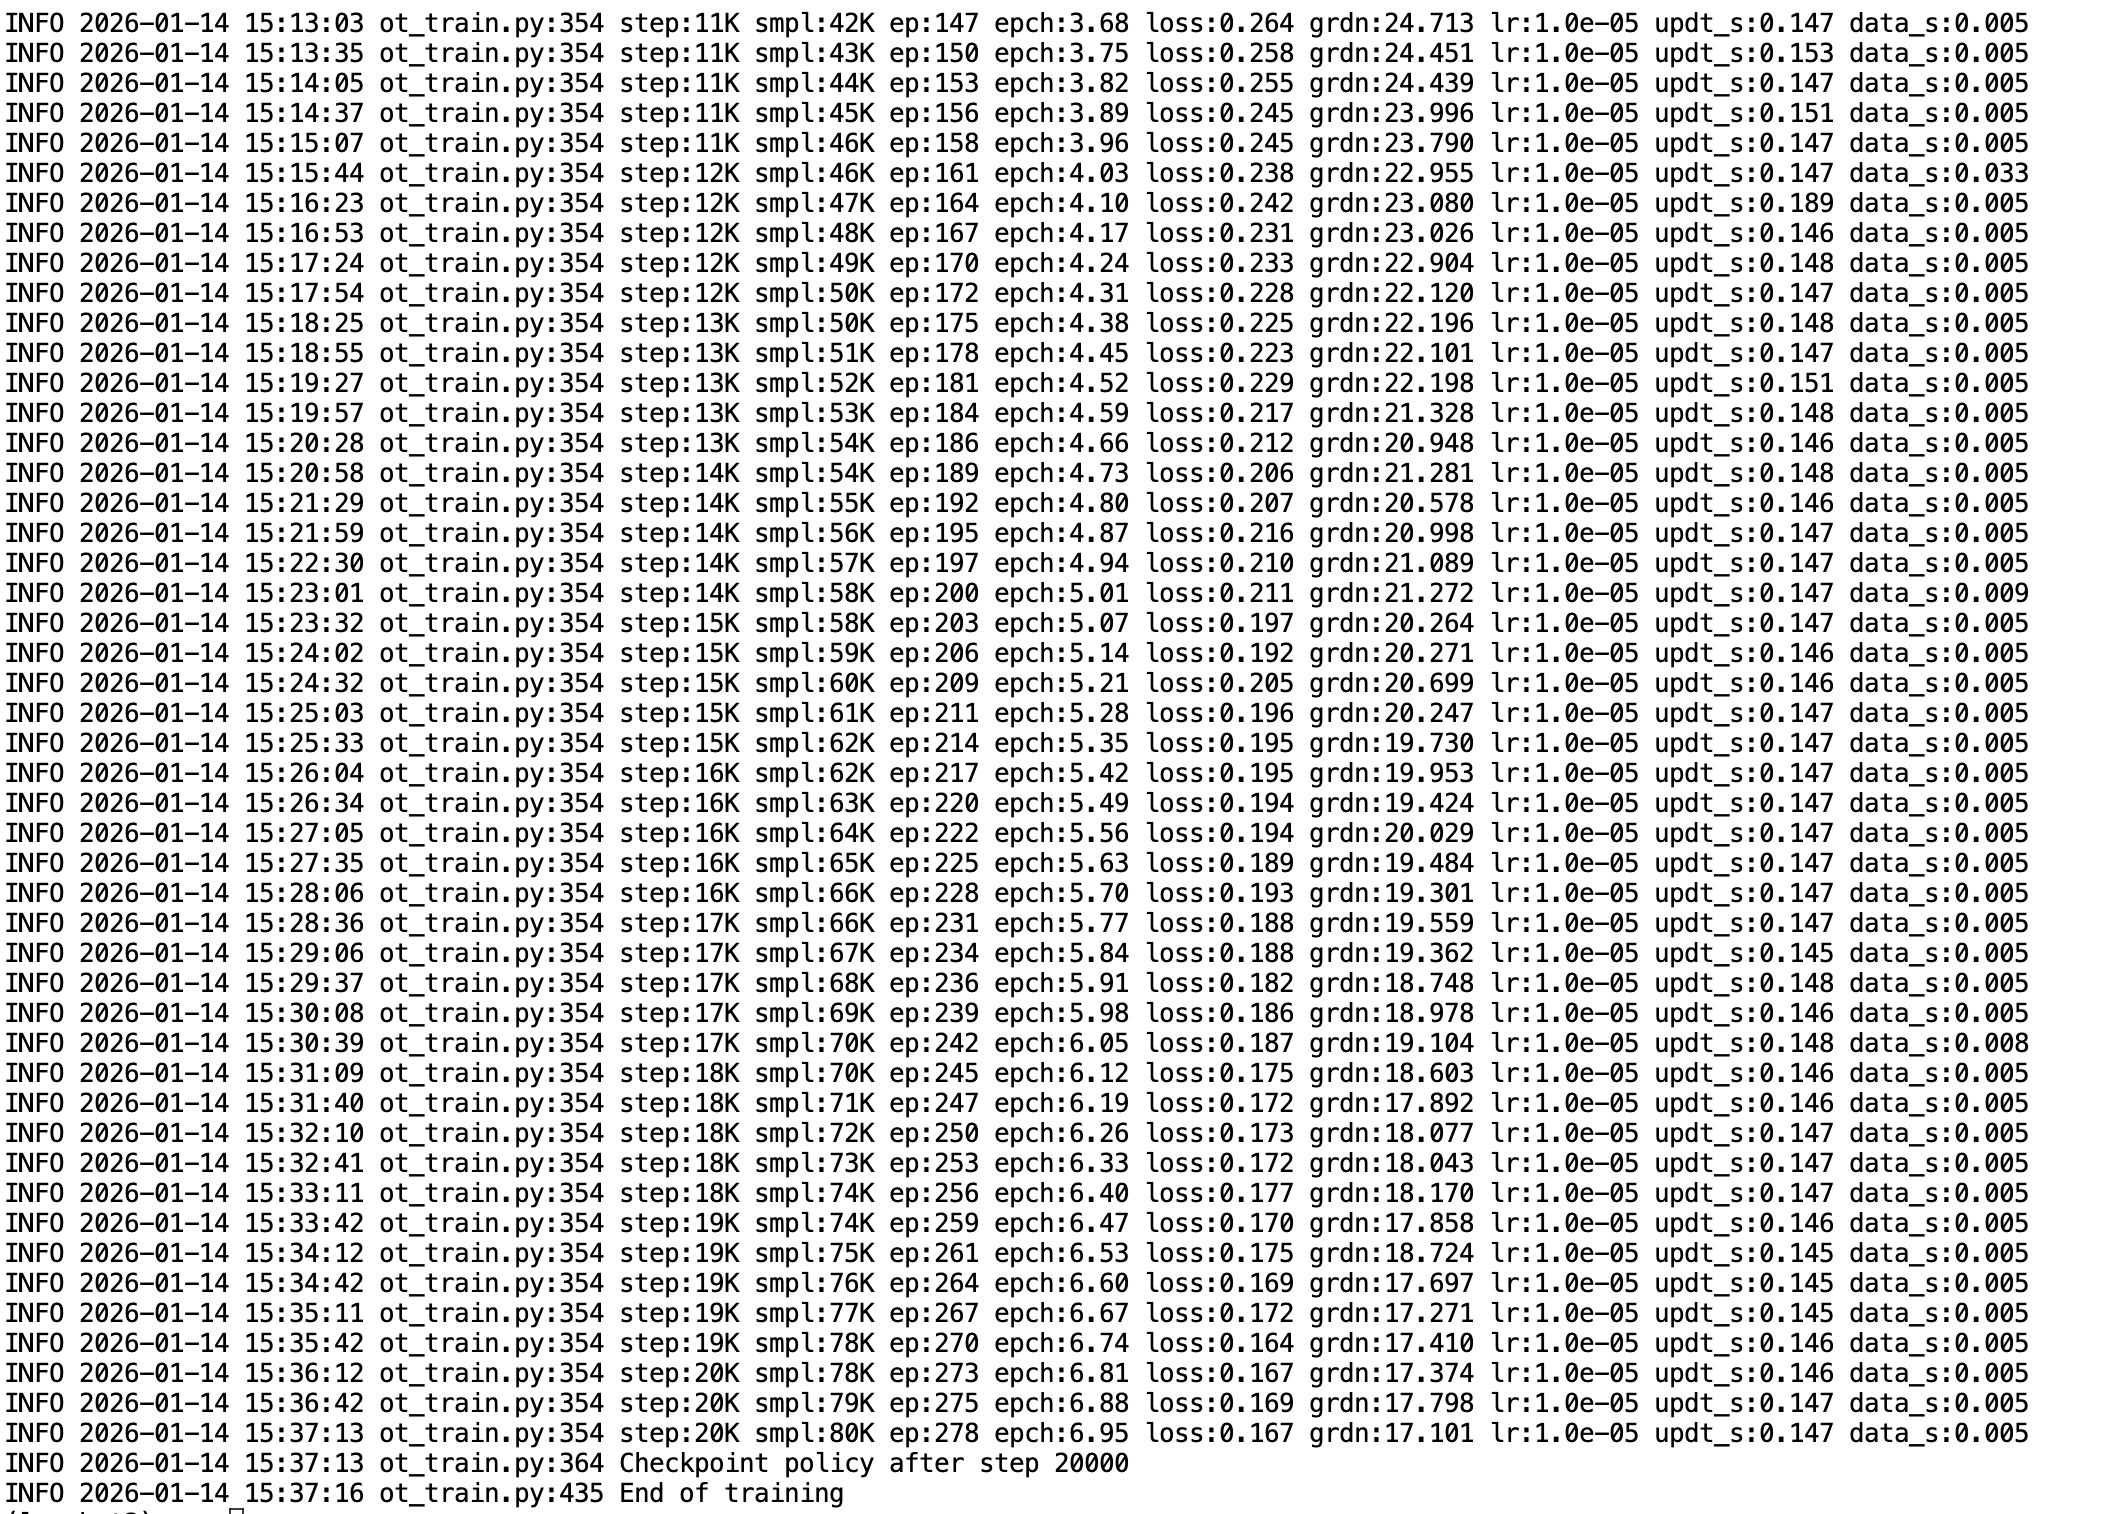
Das Modellarchiv ist etwa 300MB groß